Stratégies algorithmiques
Face à un problème nouveau, le réflexe le plus fécond de l’algorithmicien tient en une question : et si je savais déjà résoudre le même problème, en plus petit ? Trier mille cartes, c’est trier deux paquets de cinq cents, puis les fusionner. Calculer le centième terme d’une suite, c’est d’abord connaître les précédents. Trouver le plus court chemin vers Lyon, c’est d’abord le trouver vers les villes voisines.
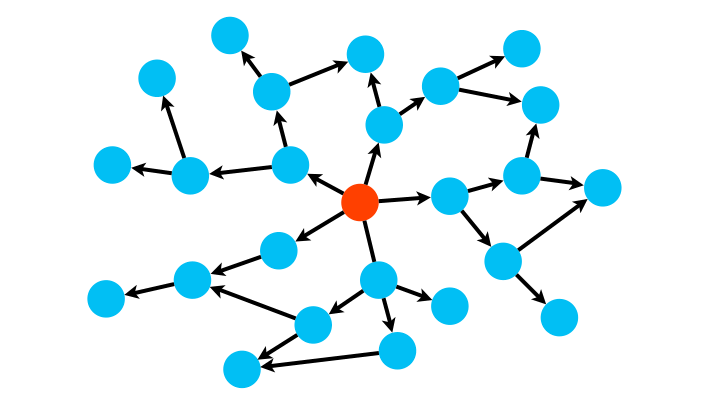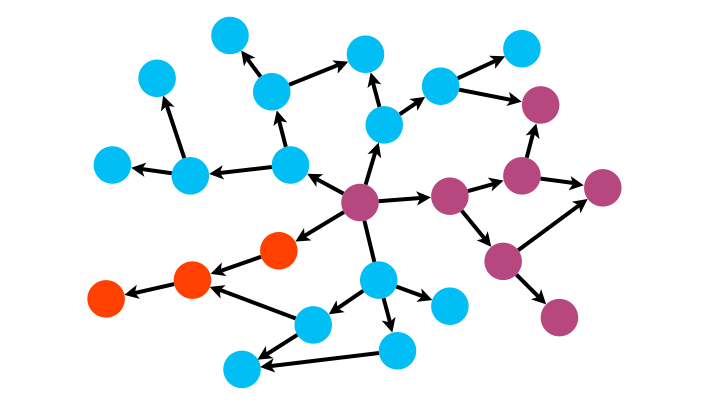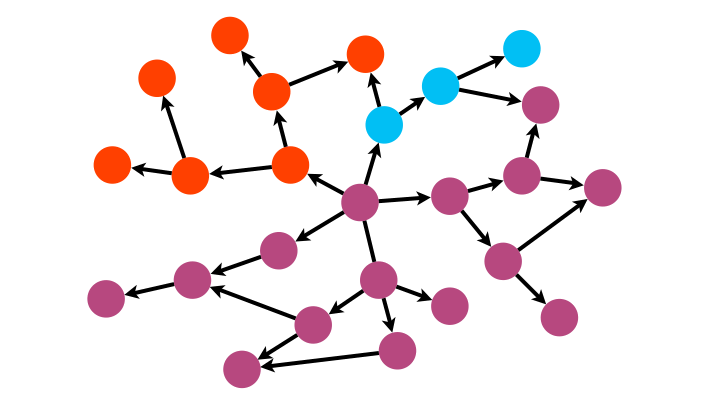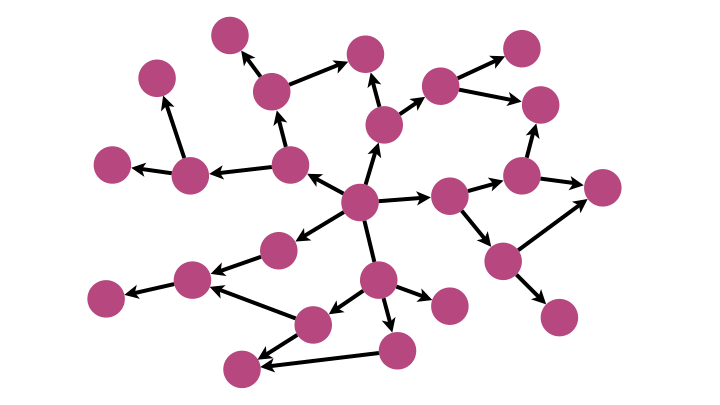
Ce geste dessine un arbre : chaque problème s’y ramifie en sous-problèmes, qui se ramifient à leur tour, jusqu’à des cas si simples qu’on les résout d’un coup. Toutes les grandes stratégies de conception, que Roughgarden appelle des paradigmes, partent de cet arbre ; elles diffèrent par ce qu’elles en font. Cette page les suit dans l’ordre où elles l’apprivoisent, avant de montrer comment le choix d’une structure de données décide de l’ordre dans lequel on le parcourt.
Le même arbre de sous-problèmes, vu par quatre stratégies.
Les complexités sont exprimées avec la notation $\mathcal{O}$, présentée sur la page Complexité, où plusieurs de ces stratégies ont déjà fait une apparition.
Le geste fondateur : la récursivité
Une fonction récursive s’appelle elle-même sur une version plus petite du problème. Deux ingrédients suffisent : un cas de base, assez simple pour être résolu directement, et la garantie que chaque appel s’en rapproche. Pour le reste, on écrit la fonction en supposant qu’elle marche déjà sur les problèmes plus petits : c’est exactement le raisonnement par récurrence des mathématiciens. Ce n’est pas toujours la forme la plus économe, mais c’est souvent la plus claire, et la récursivité sait donner un air de magie aux algorithmes en permettant à de tout petits codes de réaliser des tâches étonnamment complexes.
Les tours de Hanoï en sont l’exemple le plus célèbre. Pour déplacer $n$ disques, on déplace les $n-1$ du dessus sur le piquet intermédiaire, on déplace le grand, puis on remet les $n-1$ par-dessus. Trois lignes, et le problème est résolu.
Fonction centrale du programme ci-dessus :
def Hanoi(n, depart, cible, inter):
    if n == 1:
      deplacement(depart,cible)
    else :
      Hanoi(n-1,depart,inter,cible)
      Hanoi(1,depart,cible,inter)
      Hanoi(n-1,inter,cible,depart)

Hanoi(6, 0, 2,1)Le casse-tête est inventé en 1883 par le mathématicien Édouard Lucas, sous le pseudonyme de « N. Claus de Siam », anagramme de « Lucas d’Amiens ». Il l’accompagne d’une légende : dans un temple de Bénarès, des prêtres déplaceraient sans relâche 64 disques d’or, et le monde finirait quand ils auraient terminé.
Combien de mouvements faut-il ? Déplacer $n$ disques, c’est déplacer deux fois $n-1$ disques, plus le grand : $H(n)=2H(n-1)+1$ avec $H(1)=1$, d’où $H(n)=2^n-1$. On montre que c’est le minimum possible. Pour 64 disques, à un mouvement par seconde, il faudrait $2^{64}-1\approx 1{,}8\cdot 10^{19}$ secondes, soit environ 585 milliards d’années : le monde a de la marge.
Quand Hanoi(3, …) appelle Hanoi(2, …), le premier appel est mis en attente : il faudra y revenir, avec ses variables, à l’endroit exact où on l’a quitté. L’ordinateur empile ainsi les appels interrompus les uns sur les autres, et les reprend dans l’ordre inverse, le dernier interrompu d’abord. Cette pile d’appels est le mécanisme caché de toute récursivité. Elle a une taille limitée : Python refuse par défaut de dépasser un millier d’appels imbriqués (RecursionError). On retrouvera cette pile à la fin de l’histoire, dans le parcours des graphes.
… il faut d’abord comprendre la récursivité. Les informaticiens adorent ce genre de clin d’œil. Le système GNU doit son nom à un acronyme récursif, GNU’s Not Unix (« GNU n’est pas Unix »), dont la première lettre se déplie sans fin. Et le moteur de recherche Google, à qui l’on demande recursion, suggère malicieusement : « Did you mean: recursion ».
L’élégance a pourtant un prix. L’arbre des appels de Hanoï compte $2^n-1$ nœuds : la récursivité, à elle seule, ne rend pas un algorithme rapide. Tout dépend de la forme de l’arbre, et deux questions décident de tout. En combien de morceaux coupe-t-on le problème, et de combien rapetissent-ils ? Ces morceaux sont-ils indépendants, ou les mêmes reviennent-ils sans cesse ? La première question mène à « diviser pour régner », la seconde à la programmation dynamique.
Couper en morceaux : diviser pour régner
La stratégie tient en trois temps : diviser le problème en morceaux indépendants, les résoudre récursivement, puis combiner les réponses. On l’a vue à l’œuvre avec le plus grand sous-tableau ; elle est aussi ancienne que l’informatique elle-même, puisque John von Neumann décrit dès 1945 le tri fusion : trier chaque moitié, puis fusionner deux listes triées, ce qui se fait en un seul passage.
Combien coûte un tel algorithme ? L’arbre de récursion permet de le voir d’un coup d’œil. Supposons qu’on coupe un problème de taille $n$ en $a$ sous-problèmes de taille $n/2$, et que couper puis recombiner coûte un travail proportionnel à $n$. Au niveau $k$ de l’arbre, il y a $a^k$ sous-problèmes, chacun de taille $n/2^k$ : le travail du niveau vaut $n\,(a/2)^k$. Tout se joue donc dans la comparaison entre $a$ et $2$, c’est-à-dire entre la vitesse à laquelle les sous-problèmes se multiplient et celle à laquelle ils rapetissent.
Plus généralement, si l’on coupe en $a$ sous-problèmes de taille $n/b$ et que la combinaison coûte $\mathcal{O}(n^d)$, on compare $a$ à $b^d$ :
- si $a<b^d$, la racine domine, et le coût total est $\mathcal{O}(n^d)$ ;
- si $a=b^d$, tous les niveaux se valent, et l’on paie $\mathcal{O}(n^d\log n)$ ;
- si $a>b^d$, les feuilles dominent, et l’on paie $\mathcal{O}(n^{\log_b a})$.
Roughgarden présente ce combat avec humour : $a$, le rythme auquel les sous-problèmes prolifèrent, joue le rôle des « forces du mal », et $b^d$, le rythme auquel le travail par sous-problème fond, celui des « forces du bien ».
Multiplier plus vite qu’à l’école
L’animation l’a montré : couper chaque nombre en deux moitiés et calculer les quatre produits de moitiés donne $a=4$, et l’on retombe sur le $\mathcal{O}(n^2)$ de l’école. Diviser pour régner ne suffit pas ; il faut une idée de plus.
Pour multiplier deux nombres de $n$ chiffres, la méthode apprise à l’école calcule $n^2$ produits de chiffres. En 1960, lors d’un séminaire à Moscou, Andreï Kolmogorov conjecture qu’on ne peut pas faire mieux. Moins d’une semaine plus tard, Anatoli Karatsouba, un étudiant de 23 ans, lui apporte un contre-exemple. Kolmogorov, enthousiaste, présente le résultat et le fait publier en 1962 ; Karatsouba ne l’apprend qu’en recevant les tirés à part.
L’idée, qui remonte à une astuce de Gauss pour les nombres complexes : écrire $x=a\cdot 10^m+b$ et $y=c\cdot 10^m+d$. Le produit demande $ac$, $bd$ et $ad+bc$, soit quatre produits en apparence. Mais $ad+bc=(a+b)(c+d)-ac-bd$ : trois produits suffisent. Appliquée récursivement, cette économie fait passer de $a=4$ à $a=3$ sous-problèmes, le cas où les feuilles dominent dans l’animation : le coût tombe à $\mathcal{O}(n^{\log_2 3})\approx\mathcal{O}(n^{1{,}585})$.
En 2019, David Harvey et Joris van der Hoeven ont atteint $\mathcal{O}(n\log n)$, la limite que l’on conjecture depuis les années 1970.
Trier, « la mère de tous les problèmes »
Les tris sont omniprésents en informatique et Tim Roughgarden (auteur des géniaux Algorithms illuminated) en parle même comme de la “mère de tous les problèmes algorithmiques”.
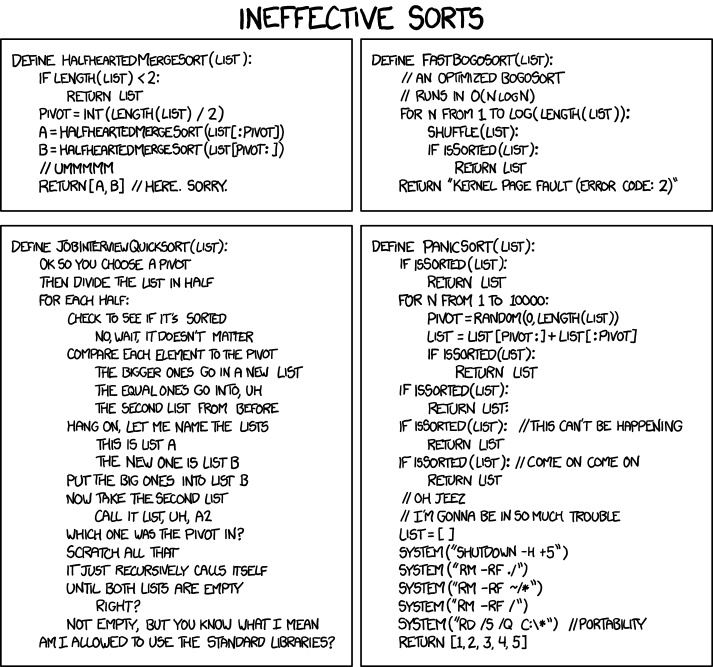
Ci-dessous, vous pourrez comparer l’efficacité de différents tris par comparaison en les voyant se débattre courageusement avec les données.
Quicksort
En 1959, Tony Hoare, jeune étudiant britannique à Moscou, travaille sur un programme de traduction automatique du russe vers l’anglais. Il doit trier les mots de chaque phrase avant de les chercher dans un dictionnaire stocké sur bande magnétique. C’est pour cela qu’il imagine Quicksort, qu’il publiera à son retour en Angleterre, en 1961. Le principe est encore « diviser pour régner », mais à l’envers du tri fusion : tout le travail se fait avant les appels récursifs, en rangeant les éléments de part et d’autre d’un pivot, et la combinaison ne coûte plus rien.
Un code Python possible pour la version détaillée dans la vidéo :
Code
from random import randint

def permute(L, i, j):
    L[i], L[j] = L[j], L[i]

def partition(L, g, d):
    p = L[g]
    i = g+1
    for j in range(g+1,d+1):
        if L[j] < p:
            permute(L,i,j)
            i += 1
    permute(L,g,i-1)
    return i-1

def tri_rapide_gd(L, g, d):
    if g < d:
        pivot = randint(g,d)
        permute(L,pivot,g)
        pivot = partition(L, g, d)
        tri_rapide_gd(L, g, pivot-1)
        tri_rapide_gd(L, pivot+1, d)
    return L

def tri_rapide(L):
    g = 0
    d = len(L)-1
    return tri_rapide_gd(L, g, d)
La danse hongroise ci-dessous implémente une version de l’algorithme sans hasard :
Dans cette version, le premier élément est systématiquement choisi comme pivot (chapeau noir) et la partition marche un peu différemment :
- Le chapeau rouge
iest d'abord donné au dernier élément de la partition puis comparé au pivotp. - Si le chapeau rouge est plus petit que le pivot, les deux éléments échangent leur place et le chapeau rouge est donné au plus proche voisin du côté du pivot.
- Sinon le pivot reste à sa place et le chapeau rouge est là aussi donné au voisin immédiat le plus proche du pivot.
- Lorsque le pivot récupère le chapeau rouge, il est bien placé.
- On coupe ensuite la liste en deux sur le pivot et on recommence récursivement.
Un code Python possible pour cette variante :
Code
def partition(L):
    p = 0         # pivot (chapeau noir)
    i = len(L)-1  # chapeau rouge
    while i != p:
      if (L[p]-L[i])*(p-i) < 0:
        L[p],L[i] = L[i],L[p]
        p,i = i,p
      i -= (i-p)//abs(i-p)
    return p

def tri_rapide(L):
    if len(L) <= 1:
      return L
    else:
      p = partition(L)
      L[:p] = tri_rapide(L[:p])
      L[p+1:] = tri_rapide(L[p+1:])
      return L
Un tirage non aléatoire du pivot rend l’algorithme moins robuste sur certaines entrées. Avec le choix systématique du premier élément (par exemple), on se retrouve avec une complexité en $O(n^2)$ sur des données déjà triées ou presque. Le tirage aléatoire rend extrêmement peu probable un scénario “défavorable”.
Si en plus de choisir le premier élément comme pivot, on ne s’occupe même plus d’avoir un tri en place (c’est-à-dire qu’on s’autorise des copies de la liste de départ), Quicksort peut s’écrire de manière très compacte :
def triRapide(elements):
    if len(elements) <= 1:
        return elements
    else:
        pivot = elements[0]
        plusPetit = triRapide([e for e in elements[1:] if e <= pivot])
        plusGrand = triRapide([e for e in elements[1:] if e > pivot])
        return plusPetit + [pivot] + plusGrand
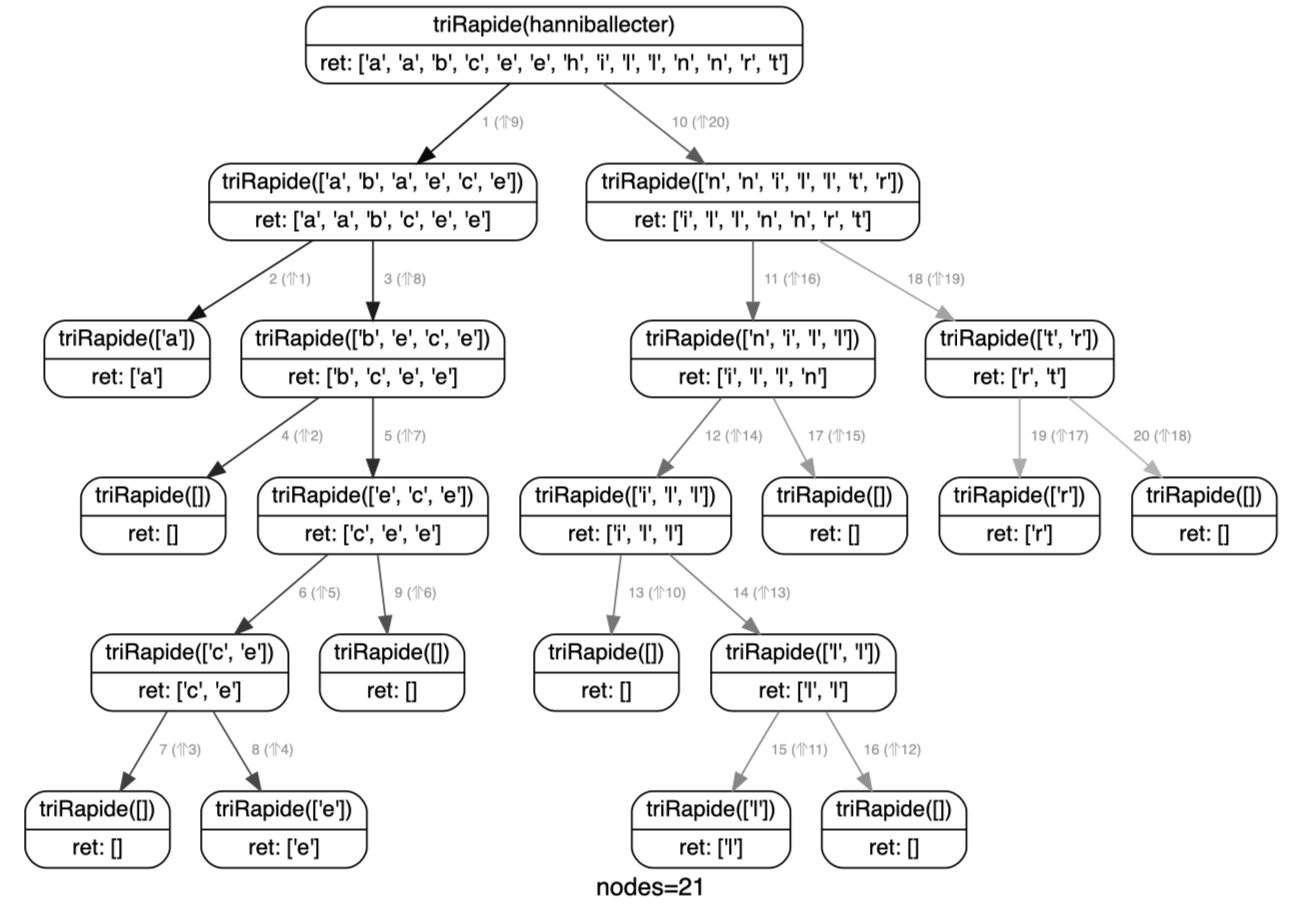
Mais attention, l’élégance de ce code cache sa lâcheté puisqu’en ne rangeant plus en place, il esquive la principale difficulté d’un algorithme de tri. S’interdire la création de nouvelles listes oblige en effet à gérer astucieusement les permutations au sein de la liste de départ. Et si cela donne souvent des codes plus verbeux, ils n’en sont pas moins beaucoup plus fins.
Le tirage aléatoire du pivot a une conséquence remarquable, que Roughgarden met en avant : pour toute entrée, le temps moyen (sur les tirages) est en $\mathcal{O}(n\log n)$. Il n’y a plus de « mauvaise entrée », seulement de mauvais tirages, et ils sont rarissimes.
Diviser pour régner repose sur une hypothèse silencieuse : les morceaux sont indépendants. Trier la moitié gauche ne dit rien de la moitié droite. Que se passe-t-il quand les sous-problèmes se recouvrent ?
Quand les sous-problèmes se répètent : la programmation dynamique
La suite de Fibonacci, $F_n=F_{n-1}+F_{n-2}$, appelle une fonction récursive immédiate. Mais son arbre des appels explose : pour calculer $F_5$, on calcule deux fois $F_3$, trois fois $F_2$, cinq fois $F_1$. Ces sous-problèmes ne sont pas indépendants, ce sont les mêmes : l’arbre n’est qu’un petit graphe déguisé.
À gauche, l'arbre des appels récursifs de $F_5$ ; à droite, le même calcul une fois les doublons fusionnés.
L’idée de la programmation dynamique est de replier l’arbre : résoudre chaque sous-problème une seule fois, ranger la réponse, et la réutiliser. On peut le faire de haut en bas, en mémorisant les résultats de la fonction récursive (c’est la mémoïsation), ou de bas en haut, en remplissant un tableau des plus petits sous-problèmes vers les plus grands.
Richard Bellman, qui invente la méthode au début des années 1950 à la RAND Corporation, a raconté d’où vient son nom. Le secrétaire à la Défense de l’époque, Charles Wilson, dont dépendait le financement de la RAND, avait « une peur et une haine pathologiques du mot recherche ». Bellman cherche donc un nom qui ne sente pas les mathématiques. Programming, au sens de planifier, convient. Et dynamic a cet avantage qu’il est impossible de l’employer dans un sens péjoratif : « c’était quelque chose à quoi même un membre du Congrès ne pourrait rien objecter ».
La logique de la programmation dynamique est présentée dans la vidéo suivante.
L’idée fondatrice de la programmation dynamique (DP) tient en une phrase : beaucoup de problèmes qui semblent exiger d’explorer un nombre exponentiel de scénarios ne comportent en réalité qu’un petit nombre de sous-problèmes distincts, chacun rencontré un très grand nombre de fois.
Dit autrement, l’arbre des possibilités est immense mais des branches très différentes de l’arbre convergent sans arrêt vers les mêmes situations. Une exploration récursive aboutirait à un graphe acyclique dense en nœuds partagés, comme celui de Fibonacci ci-dessus.
La DP consiste à identifier les sous-problèmes, à les résoudre chacun une seule fois, à stocker les résultats (la fameuse matrice), et à les combiner.
Fibonacci, quatre fois
Fibonacci offre même une petite échelle de raffinement, sur le modèle de celles de la page Complexité. La version récursive naïve recalcule sans cesse les mêmes termes : son coût croît comme $\varphi^n$, exponentiellement. En mémorisant chaque terme (c’est la programmation dynamique), on descend à $\mathcal{O}(n)$ en temps et en mémoire. En ne gardant que les deux derniers termes, la mémoire tombe à $\mathcal{O}(1)$. Enfin, les formules de doublement, $F_{2k}=F_k(2F_{k+1}-F_k)$ et $F_{2k+1}=F_k^2+F_{k+1}^2$, permettent de sauter de $k$ à $2k$ : $\mathcal{O}(\log n)$ opérations arithmétiques.
On retrouve la même idée, réduite à deux variables, dans l’algorithme de Kadane : la meilleure tranche qui se termine en $i$ se déduit de celle qui se termine en $i-1$.
Le voyageur de commerce : Held-Karp
Le problème du voyageur de commerce, rencontré à propos de P = NP, n’a pas d’algorithme polynomial connu. Le meilleur algorithme exact (non quantique), celui de Held et Karp, utilise la programmation dynamique. L’implémentation ci-dessous utilise la technique du masquage pour parcourir tous les sous-ensembles de villes visitées possibles et pour pouvoir tester rapidement l’appartenance ou non d’une ville à ce sous-ensemble.
Code
def tsp_chemin(distance, depart=0):
        """
        Résout le problème du voyageur de commerce (TSP) en utilisant une programmation dynamique basée sur les masques binaires.

        Cette fonction calcule, pour chaque sous-ensemble de villes et pour chaque ville terminale, le coût minimal pour parcourir l'ensemble des villes spécifié par le masque et terminer dans cette ville.
        Elle permet également de reconstruire le chemin optimal en stockant, pour chaque état, la ville précédente.

        Paramètres
        ----------
        distance : list[list[float]]
            Matrice des distances entre les villes, où distance[i][j] représente la distance allant de la ville i à la ville j.
        depart : int, optionnel
            Indice de la ville de départ (par défaut 0).

        Retourne
        --------
        tuple
            Un tuple (dp, parent) contenant :
              - dp : list[list[float]]
                Tableau à deux dimensions de taille (2^n x n) où dp[masque][j] est le coût minimum pour visiter
                l'ensemble de villes indiqué par le masque (représenté en binaire) et terminer à la ville j.
              - parent : list[list[int]]
                Tableau à deux dimensions de taille (2^n x n) permettant de reconstruire le chemin optimal.
                Pour chaque état (masque, j), parent[masque][j] stocke l'indice de la ville qui précède j dans le chemin optimal.

        Description
        -----------
        L'algorithme initialise une table dp avec des valeurs infinies, sauf pour l'état correspondant au départ.
        Il parcourt ensuite tous les masques possibles (correspondant aux 2^n sous-ensembles de villes) et, pour chaque ville déjà visitée, il tente de mettre à jour le coût minimal pour atteindre chaque ville non encore visitée.
        La structure parent est utilisée pour enregistrer les transitions effectuées, ce qui permet ultérieurement
        de reconstruire le chemin optimal.

        Exemple d'utilisation
        ---------------------
        >>> distance = [
        ...     [0, 10, 15, 20],
        ...     [10, 0, 35, 25],
        ...     [15, 35, 0, 30],
        ...     [20, 25, 30, 0]
        ... ]
        >>> dp, parent = tsp_chemin(distance, depart=0)
        """
        n = len(distance)
        INF = float('inf')
        dp = [[INF] * n for _ in range(1 << n)]
        parent = [[-1] * n for _ in range(1 << n)]

        dp[1 << depart][depart] = 0
        for masque in range(1 << n):  # 2^n possibilités (chaque ville est visitée ou non visitée)
            for i in range(n):
                if masque & (1 << i):  # si la ville i est visitée
                    for j in range(n):
                        if not (masque & (1 << j)):  # si la ville j n'est pas encore visitée
                            nv_masque = masque | (1 << j)
                            if dp[nv_masque][j] > dp[masque][i] + distance[i][j]:
                                dp[nv_masque][j] = dp[masque][i] + distance[i][j]
                                parent[nv_masque][j] = i
        return dp, parent
Comme à chaque fois en programmation dynamique, la matrice dp contient toutes les informations nécessaires et pour reconstruire le plus petit chemin et obtenir son coût, on peut utiliser le code suivant :
Code
def reconstr_chemin(parent, masque, dernier):
    chemin = []
    while dernier != -1:
        chemin.append(dernier)
        temp = parent[masque][dernier]
        masque = masque & ~(1 << dernier)
        dernier = temp
    chemin.reverse()
    return chemin

dp, parent = tsp_chemin(distance, depart=0)
masque_final = (1 << len(distance)) - 1
coût_min, chemin_min = float('inf'), None

for i in range(len(distance)):
    coût_total = dp[masque_final][i] + distance[i][0]
    if coût_total < coût_min:
        coût_min = coût_total
        chemin_min = reconstr_chemin(parent, masque_final, i)
        chemin_min.append(0)  # Fermer le cycle
La logique de cet algorithme repose sur la relation de récurrence suivante : $C(S,i) = \min_{j \in S,\ j \neq i} \left\{ C\left(S \setminus \{i\}, j\right) + \mathrm{d}(j,i) \right\}$ où $C(S,i)$ représente la plus petite distance pour parcourir chaque ville de l’ensemble $S$ et terminer dans la ville $i$ et $d(i,j)$ est la distance entre la ville $i$ et la ville $j$.
Sa complexité temporelle est en $\mathcal{O}(n^2 2^n)$. En effet, tous les sous-ensembles de villes sont inspectés $\mathcal{O}(2^n)$ et pour chacun, on parcourt toutes les paires ville de départ - ville d’arrivée possibles $\mathcal{O}(n)\times\mathcal{O}(n)$ sans jamais faire autre chose que des opérations en temps constant $\mathcal{O}(1)$ pour chaque paire.
La programmation dynamique explore toutes les branches, mais chacune une seule fois. Ne pourrait-on pas, parfois, être plus audacieux : à chaque embranchement, choisir une seule branche, et ne jamais revenir en arrière ?
Ne jamais revenir en arrière : les algorithmes gloutons
Un algorithme glouton construit sa solution pas à pas, en faisant à chaque étape le choix qui semble le meilleur sur le moment, sans jamais le remettre en cause. Dans l’arbre des possibles, il ne suit qu’une seule branche : c’est ce qui le rend si rapide. Les algorithmes gloutons sont très faciles à comprendre et à implémenter. Si on devait leur trouver un défaut, il est à chercher du côté de leur correction, pas toujours simple à démontrer…
L’exemple le plus familier est le rendu de monnaie : pour rendre une somme avec le moins de pièces possible, on prend toujours la plus grosse pièce qui ne dépasse pas ce qui reste. Avec les euros, ça marche à tous les coups. Avec les pièces britanniques d’avant 1971 (1, 3, 6, 12, 24 et 30 pence), ça échoue : pour rendre 48 pence, le glouton donne $30+12+6$, trois pièces, alors que deux florins, $24+24$, suffisaient. La programmation dynamique, elle, explore toutes les branches (une seule fois chacune) et trouve toujours l’optimum.
Il faut le démontrer, et l’argument classique est un échange. On prend une solution optimale quelconque, et l’on montre qu’on peut la modifier, sans la dégrader, pour qu’elle commence par le choix du glouton. De proche en proche, la solution du glouton est donc elle-même optimale. Pour les euros, cet échange marche ; pour les anciens pence, il échoue sur 48. La plupart des systèmes monétaires sont d’ailleurs conçus pour que le glouton, celui de la caissière, soit optimal.
Sont présentés ci-dessous deux algorithmes gloutons très similaires qui permettent de résoudre des problèmes d’optimisation sur des graphes :
- Dijkstra cherche le plus court chemin entre deux nœuds.
- Prim construit l’arbre couvrant de poids minimal.
Edsger Dijkstra a raconté comment il a trouvé son algorithme, en 1956, à Amsterdam : « Un matin, je faisais des courses avec ma jeune fiancée ; fatigués, nous nous sommes assis à la terrasse d’un café pour boire une tasse de café, et je me suis demandé si je pouvais faire ça. J’ai alors conçu l’algorithme du plus court chemin. C’était une invention de vingt minutes. » Sans papier ni crayon, ce qui l’obligeait, disait-il, à éviter toute complication inutile. Il s’agissait de montrer les capacités d’un nouvel ordinateur, l’ARMAC, en calculant des itinéraires entre une soixantaine de villes des Pays-Bas.
L’arbre couvrant minimal a une histoire plus longue encore : Otakar Borůvka le résout dès 1926, pour concevoir le réseau électrique de la Moravie, puis Vojtěch Jarník en 1930, et Robert Prim le redécouvre en 1957.
Ce qui rend Dijkstra rapide n’est pas seulement son idée gloutonne : c’est la structure de données qui, à chaque étape, lui tend le sommet le plus proche. C’est le dernier personnage de cette histoire.
La structure de données guide le code
« Algorithmes + structures de données = programmes. »
Niklaus Wirth, titre de son livre de 1976
Bien choisir sa structure de données, c’est souvent avoir déjà écrit l’algorithme. On l’a vu avec le doublon, où un simple ensemble fait gagner une classe de complexité, ou avec Kadane, où deux nombres suffisent à résumer tout le passé. L’exemple le plus frappant est celui des parcours de graphe, où une seule ligne change, et avec elle tout l’algorithme.
Pile, file, file de priorité : un seul parcours
Pour inventorier les sommets d’un graphe, deux stratégies sont possibles :
- le parcours en largeur (BFS),
- et le parcours en profondeur (DFS).
Le code est identique entre les deux algorithmes à la structure de données utilisée près ! On utilise une file (queue en anglais) pour le parcours en largeur et une pile pour le parcours en profondeur.
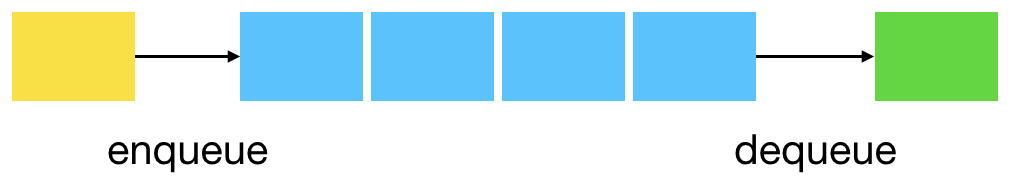
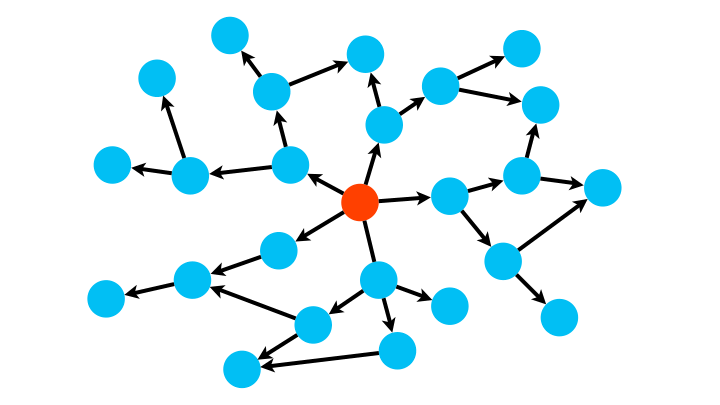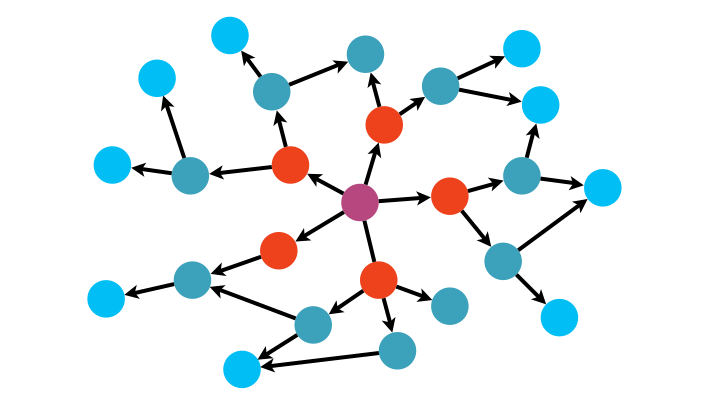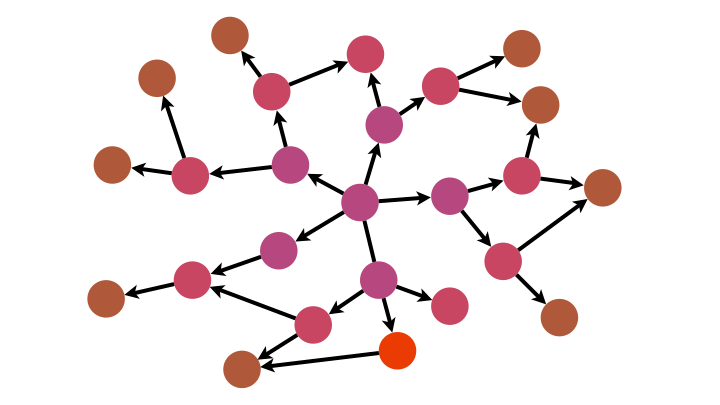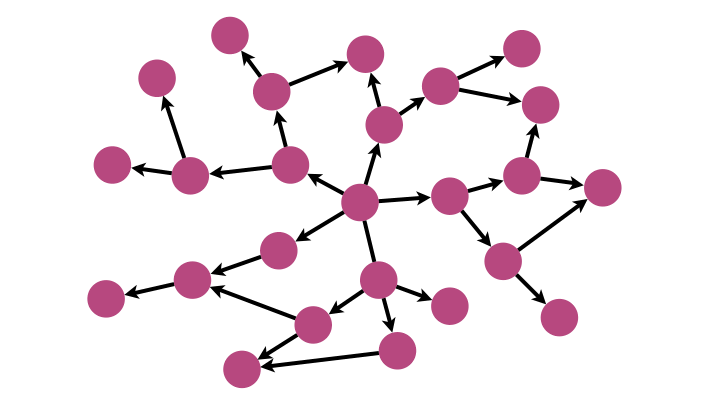
Avec sa logique FIFO (premier arrivé, premier parti, comme dans une file d’attente), BFS explore le graphe de proche en proche.
from collections import deque
# deque est une file à double extrémités (double-ended queue) avec la primitive popleft() pour retirer à gauche comme une file et pop() pour retirer à droite comme une pile.

def BFS(G,depart):
    """
    graphe G(S,A) représenté par une liste d'adjacence implémentée par un dictionnaire et depart un sommet de S
    """
    file = deque()
    file.append(depart)
    Vus = {s : False for s in G}
    Sommets = []
    while file: # tant que la file n'est pas vide
        sommet = file.popleft() # méthode de la classe deque permettant de défiler
        if not Vus[sommet]:
            file += G[sommet]
            Vus[sommet] = True
            Sommets.append(sommet)
    return Sommets
Avec sa logique LIFO (dernier arrivé, premier parti, comme pour une pile d’assiettes pendant la vaisselle), DFS s’enfonce dans une branche du graphe jusqu’à son extrémité puis revient à la dernière jonction rencontrée et explore une nouvelle branche, et ainsi de suite.
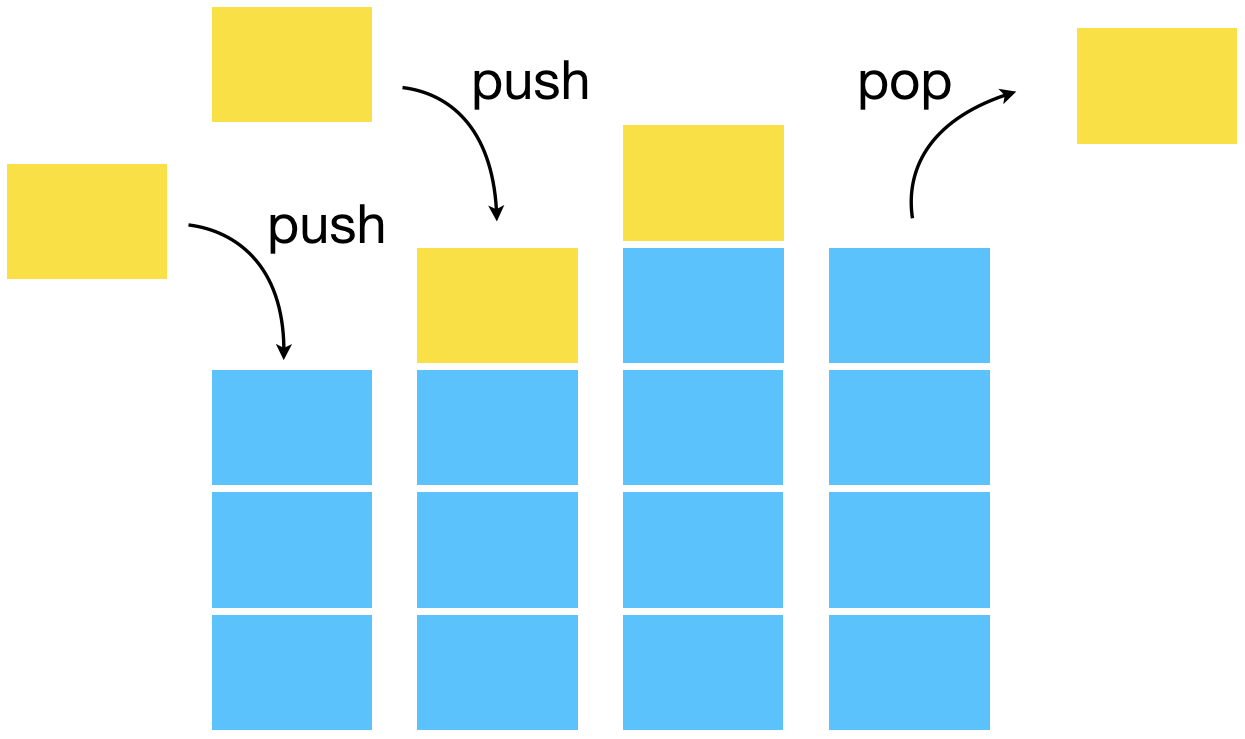
def DFS(G,depart):
    pile = deque()
    pile.append(depart)
    Vus = {s : False for s in G}
    Sommets = []
    while pile:
        sommet = pile.pop()
        if not Vus[sommet]:
            pile += G[sommet]
            Vus[sommet] = True
            Sommets.append(sommet)
    return Sommets
Comme la récursivité utilise naturellement une pile via la pile d’exécution, il y a une écriture récursive naturelle de la recherche en profondeur.
def DFS(G,depart,Vus,Sommets=None):
    if Sommets is None:      # une liste neuve à chaque appel extérieur
        Sommets = []
    Sommets.append(depart)
    Vus[depart] = True
    for sommet in G[depart]:
        if not Vus[sommet]:
            DFS(G,sommet,Vus,Sommets)
    return Sommets
Le programme ci-dessous rend cette symétrie explicite : un unique parcours, auquel on passe la façon de retirer le prochain sommet à visiter. Retirer le premier arrivé donne le parcours en largeur, retirer le dernier, le parcours en profondeur.
L’animation ci-dessous rejoue ce parcours dans un labyrinthe, de la case verte à la case rose. Clin d’œil à la section précédente : ce labyrinthe est lui-même un arbre couvrant minimal, construit par l’algorithme glouton de Kruskal sur des murs de poids aléatoires ; on y a seulement percé quelques murs de plus pour créer des boucles, sans quoi il n’existerait qu’un seul chemin. Seule change la structure qui range les cases à explorer : avec une pile, l’exploration s’enfonce dans un couloir et trouve un chemin quelconque ; avec une file, elle progresse par cercles de distance croissante et trouve le plus court ; avec une file de priorité qui sert d’abord la case la plus prometteuse (distance parcourue plus distance restante à vol d’oiseau), elle s’oriente vers le but et trouve, elle aussi, le plus court chemin. C’est l’algorithme A*, l’un des plus utilisés dans les jeux vidéo et les GPS. Dans un labyrinthe, les détours obligés limitent son avance ; en terrain dégagé, elle n’explore souvent qu’une petite fraction de ce que visite la file.
On peut voir Dijkstra comme un parcours de graphe où la structure de données n’est plus une file ou une pile mais une file de priorité, qui tend à chaque instant l’élément prioritaire, ici le sommet le plus proche du départ (avec un tas, le consulter coûte $\mathcal{O}(1)$ et le retirer $\mathcal{O}(\log n)$).
Pour implémenter une file de priorité, on peut utiliser un tas (heap), arbre binaire presque ordonné dont la racine est l’élément prioritaire.
Une implémentation possible de Dijkstra :
Code
import heapq

def Dijkstra(G, depart):
    """
    Calcule les plus courts chemins dans un graphe pondéré à partir d'un sommet de départ.

    Paramètres :
      - G : dict, représentation du graphe où les clés sont les sommets et les valeurs sont des dictionnaires {voisin: poids}.
      - depart : le sommet de départ.

    Retourne :
      - predecesseurs : dict, permettant de reconstruire les plus courts chemins.
      - distances : dict, distances minimales depuis le sommet de départ.
    """
    if depart not in G:
        raise ValueError("Le sommet de départ n'est pas présent dans le graphe")

    distances = {sommet: float('infinity') for sommet in G}
    predecesseurs = {sommet: None for sommet in G}
    distances[depart] = 0

    tas = [(0, depart)]
    while tas:
        distance_actuelle, sommet_actuel = heapq.heappop(tas)
        # On ignore l'entrée obsolète si un meilleur chemin a été trouvé
        if distance_actuelle > distances[sommet_actuel]:
            continue

        for voisin, poids in G[sommet_actuel].items():
            nouvelle_distance = distance_actuelle + poids
            if nouvelle_distance < distances[voisin]:
                distances[voisin] = nouvelle_distance
                predecesseurs[voisin] = sommet_actuel
                heapq.heappush(tas, (nouvelle_distance, voisin))
    return predecesseurs, distances
Sur une carte pondérée : quatre recherches en parallèle
Dans le labyrinthe, toutes les cases se valaient. Sur une carte de jeu vidéo, ce n’est plus le cas : l’herbe se traverse facilement (coût 1), le marécage ralentit (coût 3), le lac est très pénalisant (coût 10), et les murs sont infranchissables. La carte est tirée au hasard, mais un grand lac barre toujours la ligne droite entre le départ et l’arrivée : le chemin à vol d’oiseau est le plus court en nombre de cases, et de loin le plus cher. Quatre algorithmes partent ensemble ci-dessous, et, à chaque instant, chacun a validé le même nombre de cases.
- Le parcours en largeur ignore les pondérations : il trouve le chemin qui traverse le moins de cases, quitte à passer à la nage.
- Dijkstra valide les cases par coût croissant depuis le départ. Son chemin est le moins coûteux, mais il s’étend dans toutes les directions à la fois.
- A* ajoute à ce coût une estimation optimiste de ce qui reste à parcourir (la distance comptée comme si tout était de l’herbe). Il trouve le même coût optimal, en validant bien moins de cases.
- Le meilleur d’abord glouton ne regarde que l’estimation : il fonce vers le but sans se soucier de ce qu’il a déjà payé. Il arrive souvent le premier, mais rien ne garantit que son chemin soit bon : c’est le défaut des gloutons rencontré plus haut.
Une case est explorée quand l’algorithme la découvre : il la range dans sa structure de données avec une estimation provisoire de son coût. Elle est validée quand elle en sort. Pour Dijkstra, ce moment est décisif : la case qui sort de la file de priorité est la moins coûteuse de toutes celles qui attendent, et, les coûts étant positifs, aucun détour par une autre case ne pourra plus faire mieux. Son coût est alors définitif. A* conserve cette garantie tant que son estimation ne surestime jamais le coût réel (on la dit admissible) ; c’est le cas ici, puisqu’aucune case ne coûte moins que l’herbe.
| Structure de données | On retire… | Algorithme obtenu |
|---|---|---|
| pile | le dernier arrivé | parcours en profondeur |
| file | le premier arrivé | parcours en largeur (plus courts chemins en nombre d'arêtes) |
| file de priorité, clé = distance | le plus proche du départ | Dijkstra (plus courts chemins pondérés) |
| file de priorité, clé = distance + estimation | le plus prometteur | A* (recherche guidée) |
| file de priorité, clé = estimation seule | le plus proche du but, à vue | meilleur d'abord glouton (rapide, sans garantie) |
La boucle est bouclée. La version récursive du parcours en profondeur n’a besoin d’aucune pile explicite, puisque la pile d’appels de la récursivité en tient lieu : explorer un arbre de sous-problèmes et parcourir un graphe ne sont qu’une seule et même chose.
Épilogue : deux algorithmes où tout se rejoint
Algorithme d’Euclide
Un des plus vieux algorithmes ($\approx$-300).
La suite de Fibonacci est un peu la tarte à la crème du mathématicien de série télévisée avec ses spirales dans les coquillages… Mais c’est bien elle qui montre le bout de son nez là où on ne l’attendait pas vraiment dans cette vidéo sur la complexité de l’algorithme d’Euclide.
On peut utiliser le pulvérisateur (algorithme d’Euclide étendu) ci-dessous. Le code est corrigé par rapport à celui de la vidéo qui présente une erreur dans le cas de base (on doit retourner b, 0, 1 comme Euclide bien sûr et non a,0,1).
Et ce petit programme donne la décomposition en fraction continue :
Combien de divisions l’algorithme d’Euclide demande-t-il ? Le pire cas est atteint pour deux termes consécutifs de la suite de Fibonacci, où chaque quotient vaut $1$ et où l’on ne recule que d’un cran à chaque étape. En 1844, Gabriel Lamé en déduit que le nombre de divisions ne dépasse jamais cinq fois le nombre de chiffres du plus petit des deux nombres. C’est souvent considéré comme le premier théorème de l’histoire de la complexité algorithmique : un algorithme récursif, la suite de la programmation dynamique, et une majoration du coût dans le pire des cas, réunis dans un seul résultat.
Algorithme X
Polyominos et Sudoku ont droit à leur algorithme au nom aguicheur : X. Il résout les problèmes de couverture exacte : on dispose d’une liste de contraintes et d’une liste d’options, chaque option satisfaisant certaines contraintes, et l’on doit choisir des options de sorte que chaque contrainte soit satisfaite une et une seule fois. Paver une grille avec des pièces, c’est cela : chaque case doit être couverte exactement une fois, et chaque pièce utilisée exactement une fois.
Le Sudoku, un problème de couverture exacte
Une option, c’est un triplet $(l, c, n)$ : « mettre le chiffre $n$ dans la case de la ligne $l$ et de la colonne $c$ ». Il y en a $9 \times 9 \times 9 = 729$. Les contraintes se rangent en quatre familles de $81$, soit $324$ en tout :
| Famille | Contrainte (une par couple) | L'option $(l, c, n)$ satisfait… |
|---|---|---|
| case | la case $(l, c)$ reçoit un chiffre | la contrainte $(l, c)$ |
| ligne × chiffre | la ligne $l$ contient le chiffre $n$ | la contrainte $(l, n)$ |
| colonne × chiffre | la colonne $c$ contient le chiffre $n$ | la contrainte $(c, n)$ |
| bloc × chiffre | le bloc $b$ contient le chiffre $n$ | la contrainte $(b, n)$ |
Chaque option satisfait exactement quatre contraintes, une par famille. Une grille remplie, ce sont $81$ options qui, ensemble, satisfont chacune des $324$ contraintes une et une seule fois : $81 \times 4 = 324$, le compte est bon. Les chiffres donnés au départ ne sont que des options imposées d’avance.
L’algorithme
L’algorithme X est un retour sur trace dont chaque étape tient en quelques mots :
- s’il ne reste aucune contrainte à satisfaire, la grille est résolue ;
- sinon, on choisit la contrainte qui a le moins d’options restantes ;
- on essaie ses options une à une. Retenir une option, c’est retirer les quatre contraintes qu’elle satisfait et toutes les options qui touchent ces contraintes, devenues incompatibles. Puis on recommence sur le problème réduit ;
- si une contrainte n’a plus aucune option, c’est une impasse : on remet tout en place et l’on passe à l’option suivante du niveau précédent.
Le choix de l’étape 2 est l’élagage : plutôt que d’ouvrir l’arbre des possibles là où il est le plus touffu, on va là où il y a le moins de branches. Quand une contrainte n’a plus qu’une option, il n’y a même pas de choix à faire. L’animation ci-dessous suit l’algorithme pas à pas. À gauche, les petits chiffres gris sont les options encore vivantes ; à droite, les $324$ contraintes sont dessinées en quatre grilles de $9 \times 9$ (pour « ligne × chiffre », la rangée est la ligne et la colonne est le chiffre), colorées selon leur nombre d’options restantes.
Les amateurs de Sudoku connaissent deux réflexes de base. Le singleton nu : une case n’a plus qu’un candidat. Le singleton caché : dans une ligne, une colonne ou un bloc, un chiffre n’a plus qu’une place possible. Personne ne les a appris à l’algorithme X, et pourtant il les applique : une contrainte « case » à une seule option, c’est un singleton nu ; une contrainte « ligne × chiffre », « colonne × chiffre » ou « bloc × chiffre » à une seule option, c’est un singleton caché. Sur la grille « Facile », il ne fait que cela : aucun pari, aucun retour en arrière. Les techniques humaines apparaissent d’elles-mêmes, comme les cas particuliers d’une seule règle : aller au plus contraint.
Regardons les trois premières familles : elles correspondent aux couples $(l, c)$, $(l, n)$ et $(c, n)$. Les trois coordonnées de l’option $(l, c, n)$ y jouent des rôles parfaitement symétriques : sans les blocs, une grille de Sudoku est un carré latin, c’est-à-dire $81$ triplets tels que deux coordonnées quelconques déterminent toujours la troisième. Le joueur, lui, privilégie les cases, parce que c’est là qu’il écrit. Pour l’algorithme, « quel chiffre dans la case $(3, 5)$ ? » et « où va le $7$ dans la ligne $3$ ? » sont la même question, posée selon un autre couple de coordonnées. C’est pourquoi il trouve les singletons cachés, réputés plus difficiles à repérer, aussi facilement que les singletons nus. Seuls les blocs brisent la symétrie.
Difficile pour un humain ne veut d’ailleurs pas dire difficile pour l’algorithme. La grille « AI Escargot », présentée en 2006 par le mathématicien finlandais Arto Inkala comme la plus difficile jamais conçue, ne demande ici que $87$ retours en arrière, et celle qu’Inkala a proposée en 2012 environ $1\,400$ : quelques millisecondes pour un ordinateur. Ces nombres dépendent beaucoup de la façon de départager les contraintes qui ont le même nombre d’options : en changeant seulement cet ordre, l’Escargot peut en demander près de $1\,500$. La raison profonde est ailleurs : la couverture exacte est un problème NP-complet (comme le voyageur de commerce), et l’on ne connaît aucun algorithme efficace dans tous les cas. Pour une grille $9 \times 9$, l’élagage suffit largement ; pour des Sudoku géants $n^2 \times n^2$, l’explosion combinatoire finit toujours par gagner.
Une implémentation en Python
Ali Assaf a montré qu’avec des dictionnaires d’ensembles, l’algorithme X tient en une trentaine de lignes de Python. La version ci-dessous suit son idée. X associe à chaque contrainte l’ensemble des options qui la satisfont, et Y à chaque option la liste des contraintes qu’elle satisfait. La fonction choisir retire les contraintes satisfaites par une option, et retire les options incompatibles des autres contraintes. Elle renvoie ce qu’elle a retiré, pour que rendre puisse le remettre : rendre parcourt les mêmes boucles en sens inverse, si bien que le problème retrouve exactement son état d’avant. La recherche elle-même ne s’occupe que de choisir, essayer et revenir.
Rien dans algorithme_x, choisir et rendre ne parle de Sudoku : seule la fonction sudoku traduit la grille en contraintes et en options. Le même moteur pave un échiquier de pentominos ou place huit reines, pourvu qu’on lui décrive le problème dans sa langue.
Avec des dictionnaires, chaque retrait et chaque remise a un coût. Tout l’art de l’algorithme X tient pourtant dans la façon de revenir en arrière à moindre coût, et Donald Knuth l’a résolu en 2000 par une structure de données d’une élégance rare, les liens dansants (dancing links) : dans une liste doublement chaînée, retirer un élément $x$ se fait en deux affectations, x.gauche.droite = x.droite et x.droite.gauche = x.gauche. Or $x$ garde, lui, la mémoire de ses voisins : pour le remettre en place au moment de revenir en arrière, il suffit de deux autres affectations, x.gauche.droite = x et x.droite.gauche = x. Les éléments « dansent » hors de la liste puis y reviennent.
Récursivité pour explorer, élagage pour ne pas tout explorer, structure de données pour revenir en arrière sans rien payer : l’algorithme X rassemble à lui seul le fil de cette page.
Tim Roughgarden, Algorithms Illuminated, 4 volumes (Soundlikeyourself Publishing, 2017-2020) : les paradigmes de cette page, un volume après l’autre.
Thomas Cormen, Charles Leiserson, Ronald Rivest et Clifford Stein, Algorithmes (Dunod, 3e éd. française 2010) : la référence encyclopédique.
Donald Knuth, « Dancing Links » (2000), en accès libre sur arXiv : l’algorithme X expliqué par son auteur.
Richard Bellman, Eye of the Hurricane (World Scientific, 1984) : l’autobiographie où il raconte le choix du nom « programmation dynamique ».