Les représentations
La physique semble soumise aux symétries (jamais les solutions d’un problème ne s’affranchissent des symétries qui contraignent le système). Essence des symétries, les groupes sont l’objet idéal pour décoder ce lien indéfectible.
Mais on ne manipule pas “la physique”, seulement des objets mathématiques sensés modéliser la réalité sous-jacente. Ces objets sont toujours les solutions d’équations différentielles ou intégrales et vivent donc dans des espaces vectoriels. Le mariage entre physique et espaces vectoriels fut même entièrement consommé à l’avènement de la physique quantique puisqu’ils constituent le cadre fondamental de la théorie.
Cela serait donc sympa que l’on réussisse à balancer nos symétries dans ces espaces vectoriels… Les représentations sont là pour ça.
Une représentation, c’est la description d’un groupe dans un espace vectoriel.
Mais maintenant qu’on a un peu de vocabulaire, disons qu’une représentation d’un groupe est le résultat d’un homomorphisme de ce groupe vers le groupe des opérateurs linéaires sur les espaces vectoriels (espace des états physiques pour ce qui nous intéresse). Ces opérateurs sont incarnés par des matrices dès qu’on a une base.
On peut vérifier que les matrices carrées d’un ordre donné forment bien des groupes vis-à-vis de la loi de multiplication entre matrices si néanmoins elles ont le bon goût d’être inversibles :
- à toute matrice inversible d’ordre n correspond bien sûr une matrice inverse, elle-même inversible et d’ordre $n$,
- matrice inversible d’ordre $n$ $\times$ matrice inversible d’ordre $n$ $=$ matrice inversible d’ordre $n$,
- la multiplication de matrices est bien associative,
- la matrice identité d’ordre $n$ sert d’élément neutre.
Définition “technique” d’une représentation :
$U\left(g_1\right) U\left(g_2\right)=U\left(g_1 \cdot g_2\right)$
Et sur une base orthonormée de l’espace vectoriel (de dimension finie), l’opérateur $U$ est associé à une matrice $D$ :
$U(g)\left|e_i\right\rangle=\left|e_j\right\rangle D(g)^j_{\,i}$
Exemple du groupe de symétrie de la molécule d’ammoniac $\ce{NH3}$ :
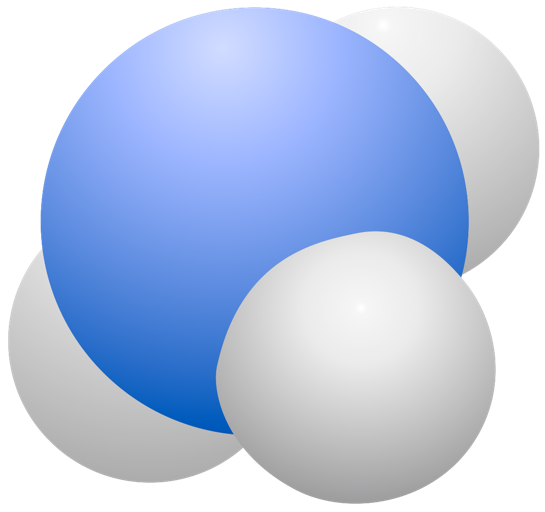
On dénombre 6 éléments de symétrie dans le groupe :
- on peut tout laisser à l’identique (élément neutre) ,
- on peut permuter circulairement les orbitales $\mathrm{s}_i$ des hydrogènes dans un sens ou dans l’autre : $\mathrm{s}_1 \rightarrow \mathrm{s}_2 \rightarrow \mathrm{s}_3 \rightarrow \mathrm{s}_1$ , $\mathrm{s}_1 \rightarrow \mathrm{s}_3 \rightarrow \mathrm{s}_2 \rightarrow \mathrm{s}_1$,
- on peut permuter deux à deux les orbitales 1s, ça fait 3 possibilités.
On vérifie à nouveau l’isomorphisme entre $\boldsymbol{S_3}$ et $\boldsymbol{D_3}$ puisque si la molécule de $\ce{NH3}$ a les symétries de $\boldsymbol{S_3}$, elle a bien aussi celles du triangle équilatéral, groupe $\boldsymbol{D_3}$ (mêmes transformations invariantes : l’identité, les 2 rotations $2\pi/3$ et $-2\pi/3$, et les 3 réflexions par rapport aux hauteurs).
L’atome d’azote est, lui, toujours laissé invariant.
On peut partir de la table de multiplication de ce groupe (voir chapitre précédent) pour construire certaines représentations.
- Représentations de dimension 1 :
- La table est respectée par une première représentation de dimension 1 plutôt triviale consistant à associer le nombre 1 à chaque élément du groupe.
- Une autre représentation de dimension 1 un peu plus intéressante consiste à représenter les rotations par des $1$ et les réflexions par des $-1$.
Une rotation suivie d’une rotation donne bien une autre rotation ($1\times 1=1$), de même qu’une réflexion suivi d’une autre réflexion ($(-1)\times (-1)=1$), alors que les compositions croisées correspondent effectivement toutes à des réflexions ($1\times(-1)=-1$). - En munissant le plan d’un repère orthonormé, on peut aussi écrire les matrices 2×2 de chacune des transformations et obtenir ainsi une représentation de dimension 2 :
-
l’identité est alors représentée par :
$$ \left(\begin{array}{ll} 1 & 0 \\ 0 & 1 \end{array}\right) $$
-
les deux permutations circulaires (ou rotation de $\pm2\pi/3$) par :
$$ \left(\begin{array}{cc} \cos (2 \pi / 3) & -\sin (2 \pi / 3) \\ \sin (2 \pi / 3) & \cos (2 \pi / 3) \end{array}\right), \left(\begin{array}{cc} \cos (4 \pi / 3) & -\sin (4 \pi / 3) \\ \sin (4 \pi / 3) & \cos (4 \pi / 3) \end{array}\right) $$
-
et les 3 permutation deux à deux (réflexions) par :
$$ \left(\begin{array}{cc} 1 & 0 \\ 0 & -1 \end{array}\right), \left(\begin{array}{cc} \cos (2 \pi / 3) & \sin (2 \pi / 3) \\ \sin (2 \pi / 3) & -\cos (2 \pi / 3) \end{array}\right), \left(\begin{array}{cc} \cos (4 \pi / 3) & \sin (4 \pi / 3) \\ \sin (4 \pi / 3) & -\cos (4 \pi / 3) \end{array}\right) $$
- On aurait aussi pu simplement partir de la base formée des 4 orbitales ($\mathrm{s_N}$, $\mathrm{s_1}$, $\mathrm{s_2}$, $\mathrm{s_3}$) et regarder ce qu’il advient de chacune. On obtient alors une représentation de dimension 4 de ce groupe de transformations :
-
l’identité s'écrit ainsi :
$$ \left(\begin{array}{llll} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{array}\right) $$
-
les deux permutations circulaires (ou rotations) :
$$ \left(\begin{array}{llll} 1 & 0 & 0 & 0 \\ 0 & 0 & 0 & 1 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \end{array}\right) , \left(\begin{array}{llll} 1 & 0 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \\ 0 & 1 & 0 & 0 \end{array}\right) $$
-
et les 3 permutation deux à deux (réflexions) :
$$ \left(\begin{array}{llll} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 0 & 1 \\ 0 & 0 & 1 & 0 \end{array}\right) , \left(\begin{array}{llll} 1 & 0 & 0 & 0 \\ 0 & 0 & 0 & 1 \\ 0 & 0 & 1 & 0 \\ 0 & 1 & 0 & 0 \end{array}\right) , \left(\begin{array}{llll} 1 & 0 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 0 & 1 \end{array}\right) $$
Cet exemple illustre le bazar que le monde des représentations peut vite devenir…
On va voir comment ranger tout ça en regroupant les représentations par classe et surtout en décomposant les représentations d’un groupe en représentations irréductibles, atomes de la théorie.
Réductibilité et irréductibilité
Pour la plupart des groupes susceptibles d’intéresser un physicien, les diverses façons de les représenter sont limitées et peuvent être répertoriées. Cela structure fortement l’espace vectoriel dans lequel joue le système physique.
Afin de classer les représentations, il faut d’abord être sûr qu’elles sont bien différentes. Pour cela, il faut vérifier qu’elles n’appartiennent pas à la même classe d’équivalence :
Soit $U(G)$ est une représentation du groupe $G$ sur l’espace vectoriel $V$ et $S$ n’importe quel opérateur inversible sur $V$.
Alors la représentation $U^{\prime}(G)$ telle que $U^{\prime}(G)=S U(G) S^{-1}$ (les matrices associées sont alors semblables) forme aussi une représentation de $G$ sur $V$, de même dimension. On dit que $U(G)$ et $U^{\prime}(G)$ sont équivalentes (on note alors $U \sim U^{\prime}$).
Et l’ensemble des représentations équivalentes forme une classe d’équivalence. Il suffit de connaître un élément de chaque classe puisqu’on peut générer tous les autres à partir de celui-ci.
On n’a fait là qu’importer la notion de classes des groupes aux représentations.
Pour répertorier les différentes représentation d’un groupe, on se concentre donc sur les représentations non équivalentes.
Et pour s’assurer que deux représentations sont équivalentes ou non, il faut une grandeur variant d’une classe à l’autre mais pas à l’intérieur d’une classe. On appelle une telle quantité un invariant de similitude (puisqu’il est identique pour deux matrices semblables). La trace en est un (ça lui donne d’ailleurs son nom : indépendante d’un changement de base, la trace caractérise la matrice) !
Mais chez les représentations, le vocabulaire s’enrichit :
Le caractère $\chi(g)$ d’un élément $g$ de $G$ dans une représentation $U(G)$ est défini comme $\chi(g)=\operatorname{Tr} U(g)$. Tous les éléments du groupe d’une même classe ont le même caractère.
Le caractère caractérise donc une classe.
Les différentes représentations équivalentes sont autant de doublons à balayer mais une autre redondance pollue aussi l’analyse : une représentation donnée peut être décrite comme la somme de ses sous-parties.
Supposons que l’on ait deux représentations $U_1(G)$ et $U_2(G)$ dans deux espaces orthogonaux $V_1$ et $V_2$. On peut alors construire une nouvelle représentation dans l’espace somme directe de $V_1$ et $V_2$ : $V_1 \oplus V_2$. La représentations est alors dite somme directe des représentations : $U(G)=U_1(G) \oplus U_2(G)$. Chacun des deux sous-espaces reste invariant sous l’action de $U$ par construction (on dit plutôt qu’ils sont laissés stables).
C’est l’opération inverse qui va nous intéresser : quand une représentation donnée peut être décomposée en sous-représentations laissant stables certains sous-espaces. La représentation est alors dite réductible.
Précisons le vocabulaire :
Un sous-espace $V_1$ de $V$ est dit stable par l’action de $U(G)$ si pour tout $g\in G$, et pour tout $x \in V_1$, $U(g) x \in V_1$.
Une représentation $U(G)$ sur $V$ est dite irréductible s’il n’y a dans $V$ aucun sous-espace propre non trivial (c’est-à-dire autre que ${0}$ et $V$ lui-même) laissé stable par l’action de $U(G)$.
Si un tel sous-espace invariant existe et si le sous-espace orthogonal est aussi invariant, alors la représentation est dite complètement réductible.
c’est le cas des représentations du groupe des translations à une dimension :
$D(a)=\left(\begin{array}{ll} 1 & a \\ 0 & 1 \end{array}\right)$
Elle laisse invariant tout vecteur $(x,0)$ mais n’a pas de sous-espace supplémentaire invariant (tentons par exemple $(0,1)$ comme sous-espace complémentaire, on se retrouve avec $D(a)(0,1)=\binom{a}{1}$ qui n’appartient pas à $\mathrm{Vect}\{(0,1)\}$ (sauf pour $a=0$).
Représentation unitaire
Une représentation unitaire $U(g)$ est définie sur un espace vectoriel muni d’un produit scalaire (donnant une norme définie positive). Un tel espace est dit préhilbertien.
La représentation unitaire doit respecter $U^{\dagger} U=1$ (où $U^\dagger$ est l’opérateur adjoint de $U$). Elle préserve les longueurs, les angles et le produit scalaire, et est donc naturellement associée aux transformations de symétrie (d’où son intérêt).
Techniquement, une représentation $U(g)$ sur un espace préhilbertien $V$ est unitaire si pour tout $g\in G$, $\langle U(g) x \mid U(g) y\rangle=\langle x \mid y\rangle$ pour tout $x,y \in V$, avec $\langle x \mid y\rangle$ désignant le produit scalaire entre les vecteurs $|x\rangle$ et $|y\rangle$.
On peut retrouver le lien entre représentation unitaire et opération de symétrie en partant d’un état physique quelconque :
Soit $|\psi\rangle$ un «vecteur d’état» d’un système sur un espace vectoriel d’états physiques. Une opération de symétrie transforme $|\psi\rangle$ en $|\psi^\prime\rangle$. Les deux ensembles de vecteurs $\{|\psi\rangle\}$ et $\{|\psi^\prime\rangle\}$ doivent fournir des descriptions équivalentes du système physique ce qui implique que l’opérateur de symétrie soit linéaire.
De plus, toute observable physique doit rester invariante sous la transformation or ces observable sont toujours exprimées sous la forme de produits scalaires du type $\langle\phi \mid \psi\rangle$. Et des transformations linéaires qui préservent le produit scalaire sont induites par des opérateurs unitaires !
Les représentations unitaires ont une propriété remarquable qui va beaucoup nous occuper :
Si une représentation unitaire est réductible alors elle est complètement réductible.
Soit $U(G)$ une représentation unitaire réductible sur $G$ et soit $V_1$ un sous-espace stable par l’action de $U(G)$, et $V_2$ le complément orthogonal à $V_1$. Il faut montrer que $V_2$ est lui aussi stable par l’action de $U(G)$.
Quels que soient $x\in V_1$ et $y\in V_2$,
$$ \begin{aligned} \langle x \mid U(g) y\rangle & =\left\langle U\left(g^{-1}\right) x \mid U\left(g^{-1}\right) U(g) y\right\rangle \\ & =\left\langle U\left(g^{-1}\right) x \mid U^{-1}(g) U(g) y\right\rangle \\ & =\left\langle U\left(g^{-1}\right) x \mid y\right\rangle=0 \end{aligned} $$
car $U\left(g^{-1}\right) x \in V_1$ comme $U(g)(x)$.
Par conséquent $U(g)y$ appartient à l’espace orthogonal à $V_1$, c’est-à-dire $V_2$, et ce pour tout $g\in G$.
Conclusion, l’espace $V_2$ est stable sous l’action de $G$.
Donc une représentation unitaire pourra toujours s’écrire comme la somme directe de ses représentations irréductibles et non équivalentes (des représentations équivalentes vivent dans le même sous-espace) :
$$ \begin{aligned} U(G)&=\underbrace{U^1(G) \oplus \cdots \oplus U^1(G)}_{a_1\text{ termes}} \oplus \underbrace{U^2(G) \oplus \cdots \oplus U^2(G)}_{a_2\text{ termes}} \oplus \cdots\\ &=\sum_{\mu \oplus} a_\mu U^\mu(g) \end{aligned} $$
où $a_\mu$ est le nombre de fois que la représentation irréductible $\mu$ apparaît dans la décomposition (à ne pas confondre avec $n_\mu$, sa dimension).
Tout ce qui va suivre découle de cette décomposition…
Avec le bon choix de base, les matrices de la représentation $U(g)$ apparaîtront donc diagonales par bloc.
$$ D(g)=\left(\begin{array}{cccc} D^1(g) & 0 & \cdots & 0 \\ 0 & D^2(g) & \cdots & \vdots \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \cdots & D^k(g) \end{array}\right) $$
Pour tout $g,g^\prime \in G$,
$$ D(g) D(g^{\prime})=\left(\begin{array}{cccc} D^1(g) D^1(g^{\prime}) & 0 & \cdots & 0 \\ 0 & D^2(g) D^2(g^{\prime}) & \cdots & \vdots \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \cdots & D^k(g) D^k(g^{\prime}) \end{array}\right) $$
Le non croisement des termes montre que $D(G)$ ne contient pas de nouvelles informations par rapport à l’ensemble des $D_i(G)$ justifiant que l’on puisse parler de redondance entre une représentation et l’ensemble de ses représentations irréductibles.
Cette décomposition n’est a priori possible que pour des représentations unitaires mais c’est finalement peu restreignant car outre le fait que les groupes de symétrie qui intéressent le physicien sont naturellement associés à des transformations unitaires, toute représentation d’un groupe fini ou compact (éléments variant sur un espace compact) est équivalente à une représentation unitaire.
En effet, toute représentation d’un groupe fini sur un espace doté d’un produit scalaire est équivalente à une représentation unitaire.
À partir du produit scalaire $\langle x \mid y\rangle$ défini sur l’espace vectoriel $V$, on en construit un nouveau, toujours sur $V$, en opérant une sorte de moyennage sur l’action du groupe $G$ (cette astuce de passage par la moyenne va beaucoup nous servir) :
$(x, y) \equiv \sum_g\langle D(g) x \mid D(g) y\rangle$
$(.\,,.)$ a bien les propriétés d’un produit scalaire : bilinéaire, symétrique, positif, défini.
Passons maintenant de la base orthonormée $\{e_i\}$ adaptée à l’ancien produit scalaire, telle que $\left\langle e_i \mid e_j\right\rangle=\delta_{i j}$ à une base $\{f_i\}$ adaptée au nouveau, telle que $\left(f_i, f_j\right)=\delta_{i j}$. Soit $S$ la matrice de changement de base : $f_i=S_i^{\,j} e_j$.
On a ainsi : $(x, y)=\langle S x \mid S y\rangle$ pour tout $x$ et $y$ dans $V$.
La représentation $U(g)=S D(g) S^{-1}$, équivalente à $D(g)$, est alors unitaire.
En effet :
La preuve précédente est généralisable aux groupes compacts en remplaçant la somme dans la moyenne par une intégrale mais ça devient un peu plus technique.
Savoir qu’une représentation est réductible nous fait une belle jambe tant qu’on ne sait pas distinguer une représentation déjà réduite d’une représentation pouvant l’être. Car si la matrice associée n’a pas le bon goût d’être d’ores et déjà diagonale par bloc, comment fait-on ? Et quand s’arrête-t-on d’essayer de réduire ?
Une propriété capitale de la théorie des représentations va nous donner les clés pour opérer cette diagonalisation par bloc jusqu’au bout : les représentations irréductibles forment une base orthonormée de l’espace des représentations du groupe.
Conditions d’orthonormalité et de complétude pour les représentations irréductibles
On obtient de haute lutte les relations suivantes :
- Une condition d’orthonormalité entre les représentations irréductibles (le «produit scalaire» entre deux représentations irréductibles identiques vaut 1, c’est ce qu’on nomme normalité, et est nul dans les autres cas, c’est l’orthogonalité) :
$\displaystyle \frac{n_\mu}{n_G} \sum_g D_\mu^{\dagger}(g)^k_i \, D^\nu(g)^j_l=\delta^\nu_\mu \, \delta^j_i \,\delta^k_l$
- Et une conditions de complétude (le mot a beau sonné vilain, il traduit que le pavage de l’espace des représentations par les morceaux irréductibles est complet) :
$\displaystyle \sum_{\mu, l, k} \frac{n_\mu}{n_G} D^\mu(g)^l_k \, D_\mu^{\dagger}\left(g^{\prime}\right)^k_l=\delta^g_{g^{\prime}}$
- Le caractère complet est démontré par la très importante ultime relation :
$\displaystyle\sum_\mu n_\mu^2=n_G$
Les conditions d’orthonormalité sont élevées au rang de Great Orthogonality Theorem (GOT) chez les anglo-saxons.
On peut les réécrire en notant à la manière quantique $\langle g \mid \nu, j, l\rangle=\sqrt{\frac{n_\nu}{n_G}} D^\nu(g)^j_l$ pour insister sur la nature «vectorielle» de ces relations :
$$\displaystyle\sum_g\langle\mu, i, k \mid g\rangle\langle g \mid \nu, j, l\rangle=\delta^\nu_\mu \,\delta^j_i \, \delta^k_l$$
Cette forme permet d’appréhender plus facilement son interprétation géométrique. Il faut s’imaginer un espace vectoriel complexe à $n_G$ dimensions où chaque axe correspond à un élément du groupe.
Chaque $D^\mu(g)^j_i$ peut donc être vues comme un «vecteur» à $n_G$ composantes (avec $g$ parcourant $G$), tous orthogonaux entre eux. Le premier de ces vecteurs serait par exemple :
$ \left(D^1(e)^1_1, D^1\left(g_1\right)^1_1, D^1\left(g_2\right)^1_1, \ldots, D^1\left(g_{n_G}\right)^1_1\right) $
On peut aussi réécrire à la manière quantique la relation de complétude :
$$\sum_{\mu, l, k}\langle g \mid \mu, l, k\rangle\left\langle\mu, l, k \mid g^{\prime}\right\rangle=\delta^g_{g^{\prime}}$$
On s’applique en mécanique quantique à vérifier des relations du même type sur les vecteurs de base de l’espace vectoriel des états (c’est d’ailleurs une des motivations pour la notation compacte en bra-ket adoptée ici). Mais au terme «complétude», les quanticiens préfèrent la mieux tournée «relation de fermeture» dont le contenu est le même ; il s’agit de prouver que l’espace ainsi décomposé est complet, c’est-à-dire que tout état peut se décomposer sur les vecteurs de base.
La démonstration de l’orthonormalité s’appuie sur le lemme de Schur qu’on va détailler tout de suite (les relations précédentes sont d’ailleurs parfois appelées relations d’orthogonalité de Schur) et la complétude repose sur les représentations régulières qu’on décrira plus loin.
Opérateur d’entrelacement
Avant d’arriver au lemme de Schur, il nous faut introduire un nouvel opérateur qui généralise la notion d’homomorphisme d’une représentation à une autre.
Prenons une représentation $U_1(G)$ d’un groupe $G$ dans un espace vectoriel $V_1$ envoyant un vecteur $v_1$ quelconque vers un vecteur $v^\prime_1$ pour un certain élément $g$ de $G$ et une représentation $U_2(G)$ du même groupe $G$ dans un espace $V_2$ envoyant un vecteur $v_2$ vers un vecteur $v^\prime_2$ toujours pour le même élément $g$. On aimerait qu’un homomorphisme $A$ de l’une à l’autre de ces représentations conserve leurs actions en associant parallèlement les vecteurs modifiés pour chaque $g$.
Pour être plus clair : si $A$ envoie $v_1$ sur $v_2$, on voudrait alors du même coup que $v^\prime_1$ soit envoyé sur $v^\prime_2$.
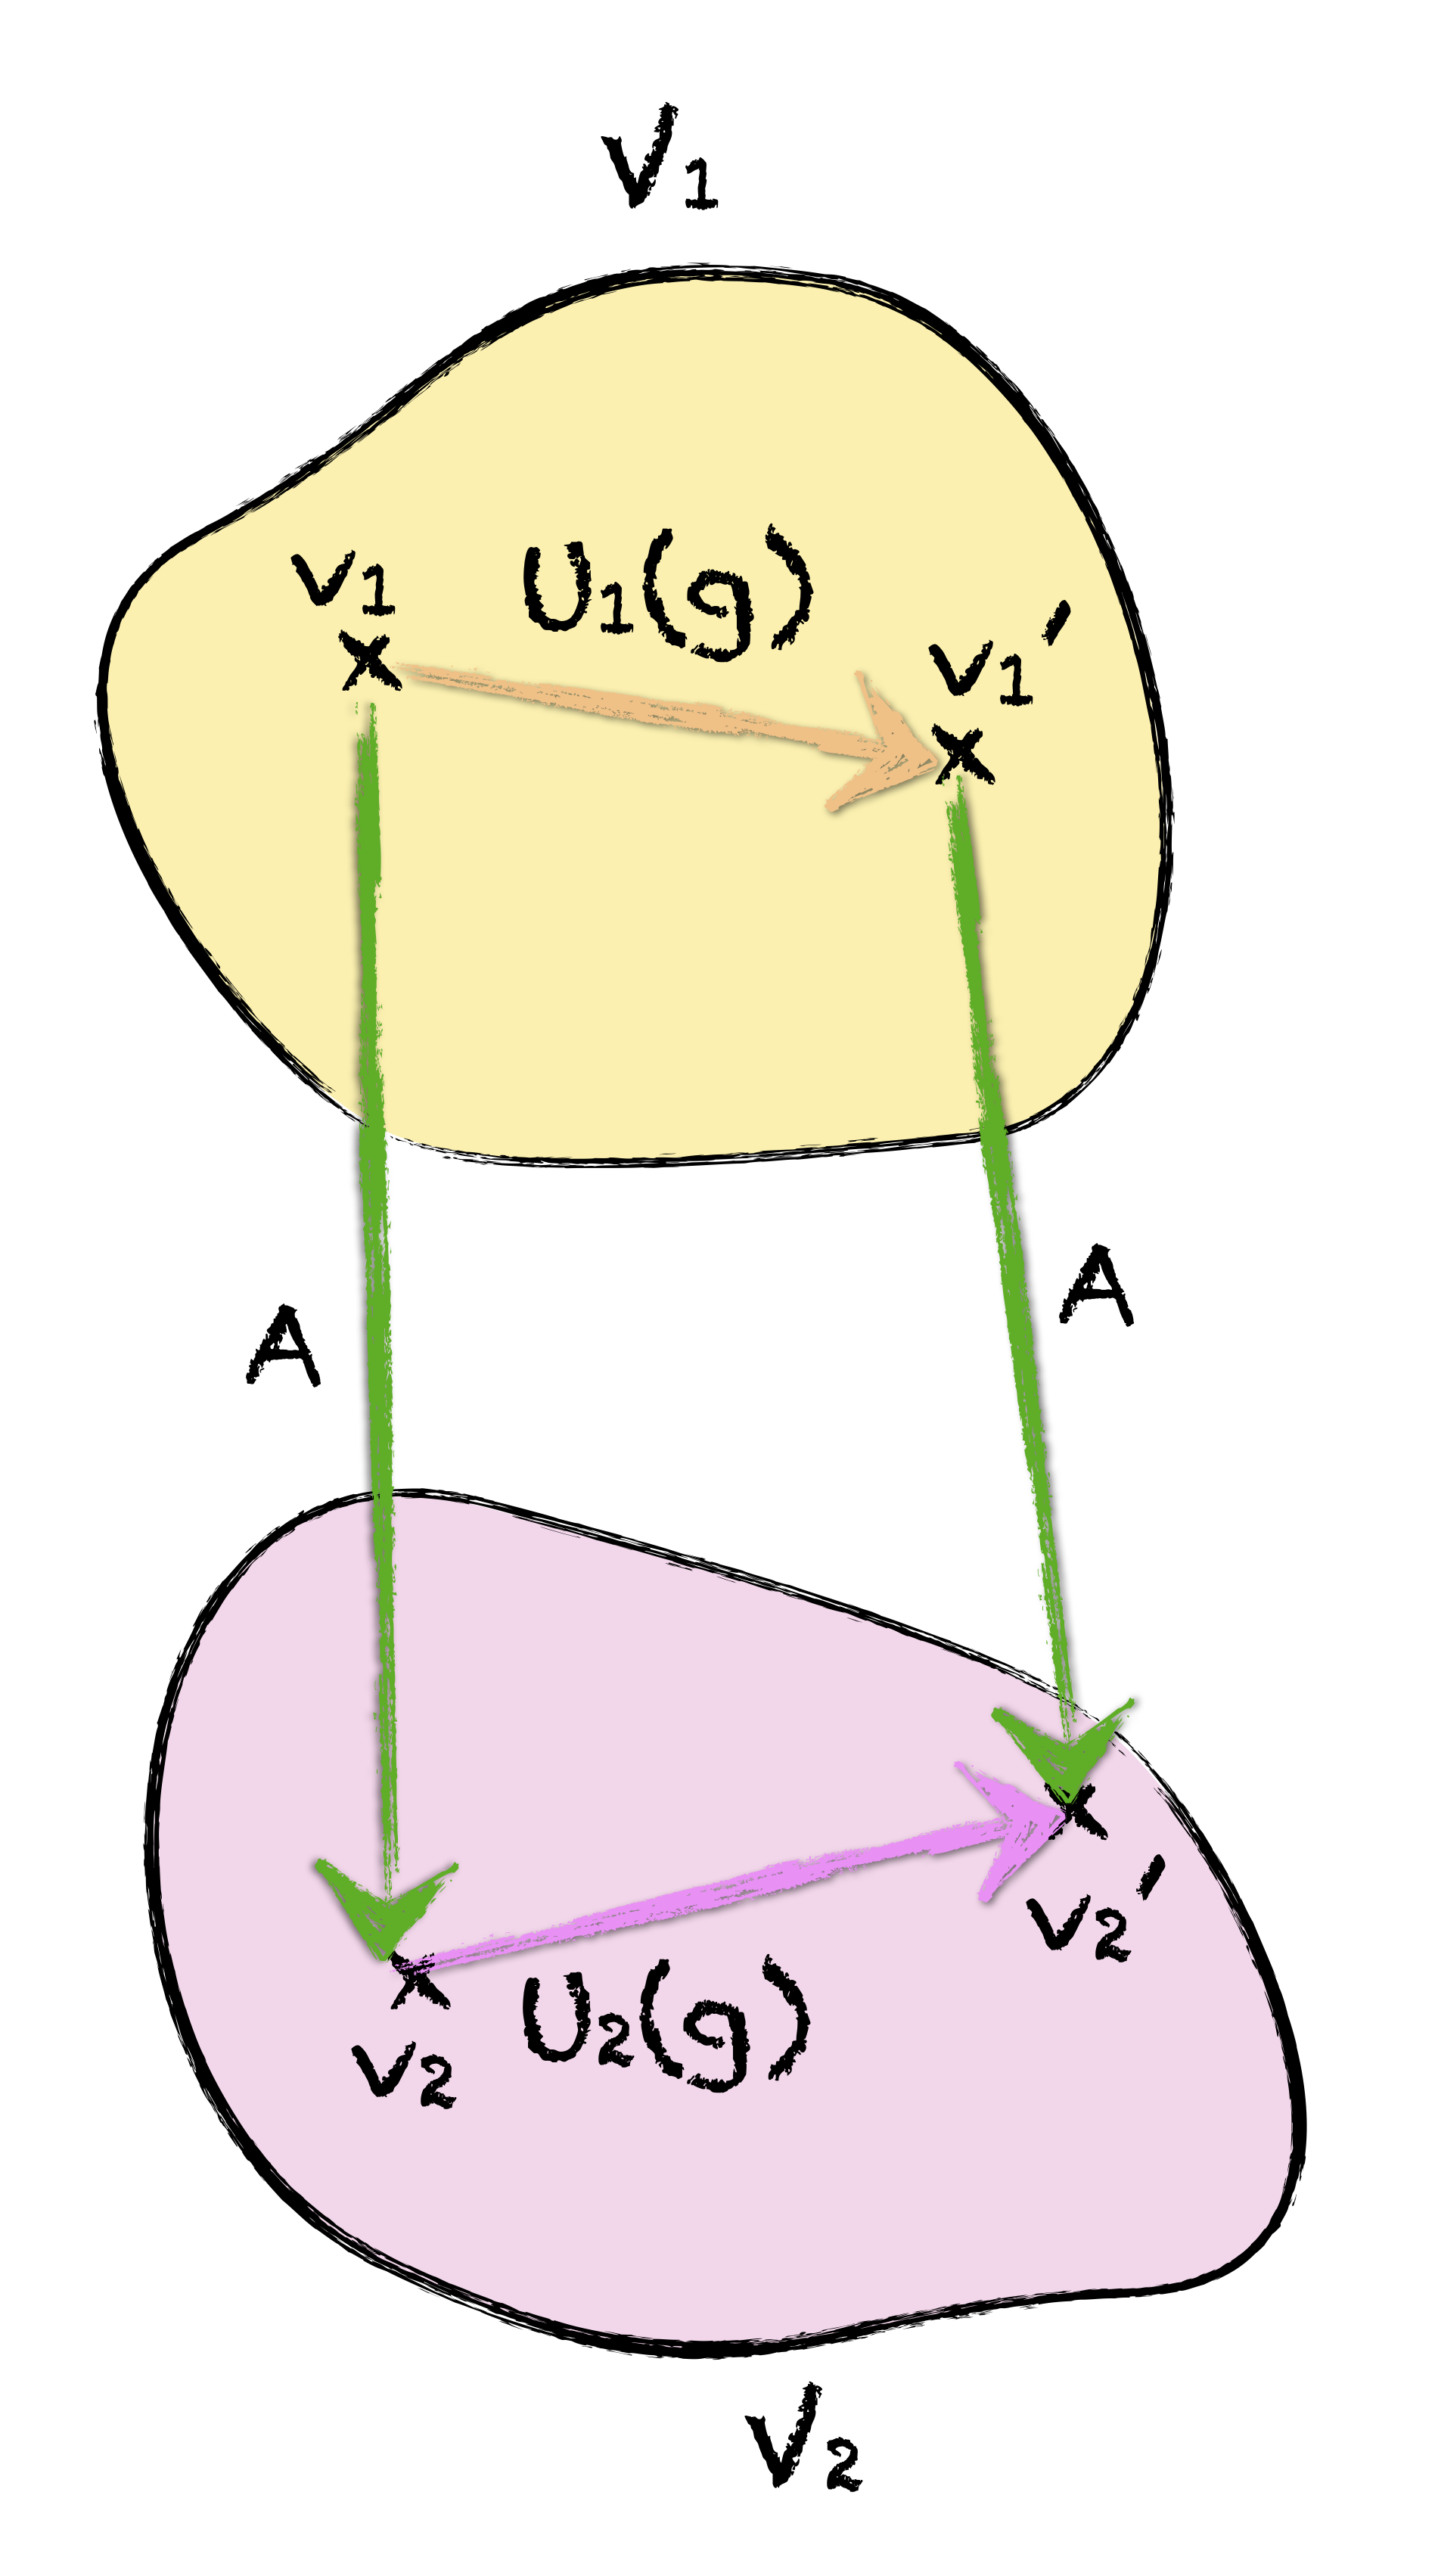
On aurait ainsi $v_2^{\prime}=U_2(g) v_2=U_2(g) A v_1=A v_1^{\prime}=A U_1(g) v_1$.
Formalisons :
Soient $U_1(G) \in V_1$ et $U_2(G) \in V_2$ deux représentations. L’opérateur d’entrelacement $A$ (ou homomorphisme de représentations) est une application linéaire de $V_1$ sur $V_2$ tel que $A U_1(g)=U_2(g) A$ pour tout $g\in G$.
On dit que $A$ entrelace $U_1$ et $U_2$ ce qui est plutôt mignon.
On dit aussi que $A$ est une application G-équivariante, sobriquet assez parlant bien que moins poétique.
Et pour les esprits schématiques, l’opérateur d’entrelacement peut aussi être définit tel que le diagramme suivant commute pour tout $g\in G$, le chemin rouge et le chemin bleu arrivant au même endroit :
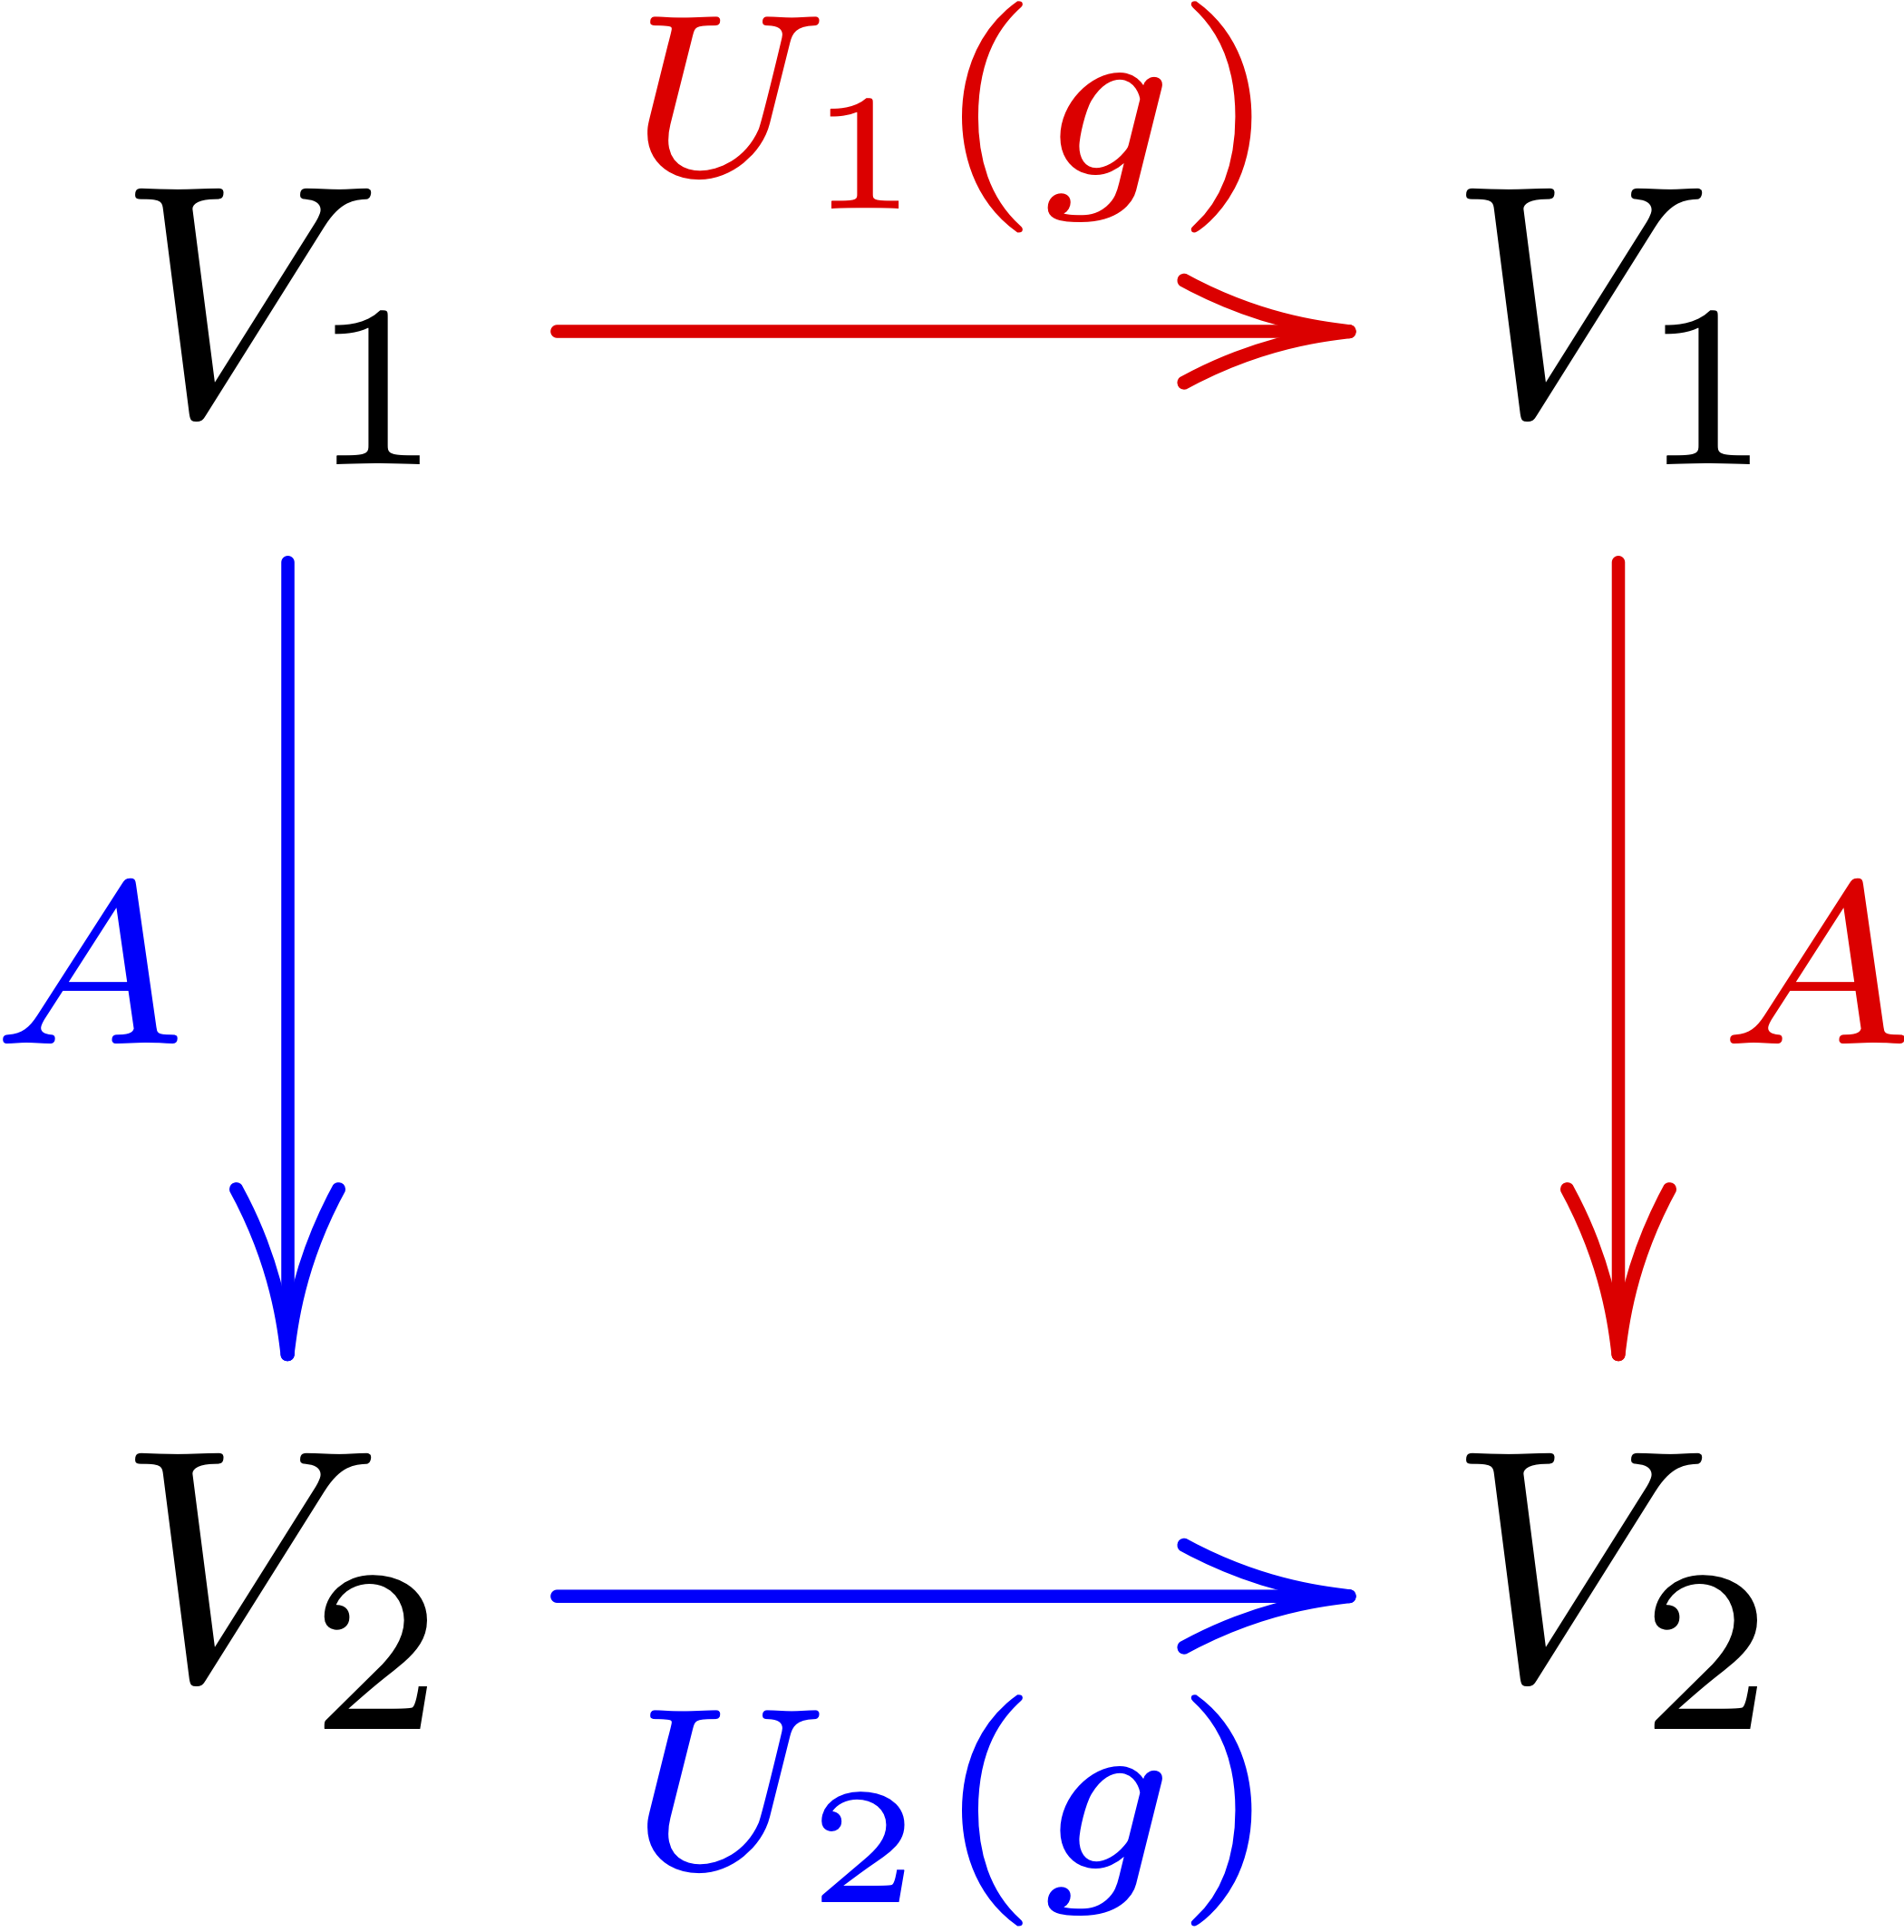
L’ensemble de tous les opérateurs d’entrelacement de $U_1$ à $U_2$ est noté $\operatorname{Hom}_G\left(U_1, U_2\right)$.
Lemme de Schur
Soit $U_1(G)$ et $U_2(G)$ deux représentations irréductible d’un groupe $G$ sur des espaces vectoriels $V_1$ et $V_2$ et $A \in \operatorname{Hom}_G\left(U_1, U_2\right)$, un opérateur d’entrelacement.
On a alors : soit $A=0$, soit $V_1$ et $V_2$ sont isomorphes et les représentations $U_1$ et $U_2$ sont équivalentes.
Si $A=0$, il n’y a rien à démontrer. Supposons alors $A≠0$.
- Montrons que $A$ est surjectif :
comme $A≠0$, il existe au moins deux vecteurs $v_2$ et $v_1$ respectivement de $V_2$ et $V_1$ tels que $v_2=A v_1$.
Et pour tout $g\in G$, on a : $U_2(g) v_2=U_2(g) A v_1=A\left(U_1(g) v_1\right)$ qui appartient à $A V_1$.
Par conséquent, $A V_1$ est un sous-espace stable non nul de $V_2$ par rapport à $U_2$ et comme $U_2$ est irréductible, on doit avoir $AV_1 = V_2$ . - Montrons que $A$ est injectif :
soit maintenant $W$ le noyau de $A$. $A$ est une application linéaire, or le noyau d’une application linéaire change un tantinet de ceux côtoyés jusqu’ici puisque l’élément neutre n’est plus l’identité mais le vecteur nul (la composition interne considérée est l’addition). Le noyau étant définit comme l’ensemble aboutissant à l’élément neutre, on a $W=\left\{v_1 \in V_1 ; A v_1=0\right\}$.
Prenons un élément $v_1$ de ce noyau. Alors $A\left(U_1(g) v_1\right)=U_2(g) A v_1=U_2(g) 0=0$, donc $U_1(g) v_1$ appartient à $W$ et ce, pour tout $g$. Ce qui implique que $W$ est un sous-espace invariant de $V_1$ pour $U_1$, or comme $U_1$ est irréductible, soit $W=V_1$ mais alors $A=0$, soit $W=\{0\}$ (injection).
$A$ est donc une application bijective entre $V_1$ et $V_2$, ce qui implique que ces deux espaces soient isomorphes.
D’autre part, comme le noyau de $A$ est le vecteur nul, $A$ est inversible et de $U_2(g) A v_1=A\left(U_1(g) v_1\right)$, on déduit $U_2(g)=A U_1(g) A^{-1}$ pour tout $g\in G$.
Les deux représentations sont bien équivalentes.
On tire un intéressant corollaire du lemme de Schur :
Soit $U(G)$ une représentation irréductible et de dimension finie de $G$ dans l’espace vectoriel $V$ complexe. Alors, un homomorphisme de la représentation de $U$ sur elle-même (automorphisme appartenant à $\operatorname{Hom}_G(U, U)$) est un multiple de la matrice identité $E$.
soit $A$ un opérateur de cet homomorphisme et soit une valeur propre $λ \in \mathbb{C}$ de $A$ (comme $A$ est inversible et de dim finie sur un espace vectoriel complexe, il y en a forcément au moins une). $A- λE$ appartient aussi à l’automorphisme puisque $E$ en fait partie et qu’on joue avec des applications linéaires (la loi de composition de groupe, si on peut encore l’appeler ainsi, est justement la combinaison linéaire d’éléments).
Mais par définition d’une valeur propre, $A- λE$ n’est pas inversible donc d’après le lemme, il ne peut s’agir que de l’élément nul (le lemme dit : soit isomorphisme soit zéro).
Remarque :
C’est la première fois qu’on s’impose de travailler sur un espace vectoriel complexe. Lui-seul permet d’affirmer qu’un opérateur linéaire sur un espace vectoriel de dimension finie possède une valeur propre. C’est une conséquence de l’existence d’une racine pour tout polynôme de degré ≥ 1 dans $\mathbb{C}$ (le théorème fondamental de l’algèbre dit bien qu’un polynôme de degré $n$ a $n$ racines). En particulier, le polynôme caractéristique de l’opérateur a donc une racine.
Et cela marche aussi pour un espace vectoriel complexe de dimension infinie mais complet, ce qui permet d’étendre la propriété aux cas qu’on rencontrera dans les chapitres suivants.
Notons que l’automorphisme d’une représentations commute, par définition, avec tous les éléments de cette représentation.
Par conséquent, la propriété peut se reformuler ainsi :
Soit $U(G)$ une représentation irréductible d’un groupe $G$ dans un espace vectoriel $V$.
Un opérateur $A$ de $V$ commutant avec tous les opérateurs ${U(g), g \in G}$ est un multiple de l’identité.
On utilise cette propriété pour débusquer les opérateurs de Casimir comme $\vec{J}^{,2}$ (d’Henrik Casimir, physicien hollandais).
Et on en déduit aussi (corollaire du corollaire) :
Toute représentation irréductible d’un groupe abélien est de dimension 1.
Soit $U(G)$ une représentation irréductible du groupe abélien $G$. Soit $p$ un élément de $G$. Comme $G$ est abélien, on a $U(p) U(g)=U(g) U(p)$ pour tout $g\in G$.
D’après le lemme de Schur, on a alors $U(p)=\lambda_p E$. Et cela marche pour tout les $p\in G$. Par conséquent, la représentation $U(G)$ est équivalente à la représentation unidimensionnelle $p \rightarrow \lambda_p \in \mathbb{C}$ pour tous les $p\in G$.
En physique, ces considérations généralisent un résultat bien connu : des opérateurs qui commutent possèdent un jeu complet de vecteurs propres communs (cf. la recherche d’un «ECOC», ensemble complet d’observables qui commutent, en mécanique quantique).
Précisons cela dans le cas de l’Hamiltonien.
La dynamique d’un système physique est déterminée par un opérateur appelé l’Hamiltonien $H$ et cet opérateur doit, par définition, rester invariant sous les opérations de symétrie laissant invariant le système physique lui-même.
Mathématiquement, cela revient à dire que $H$ commute avec les opérateurs unitaires de la symétrie considérée. Et par conséquent, dans une représentation irréductible donnée du groupe de symétrie, l’Hamiltonien a pour représentation un multiple de la matrice identité.
En d’autres mots, tous les vecteurs de la représentation irréductible sont des vecteurs propres de l’Hamiltonien pour la même valeur propre.
Cette valeur propre de l’Hamiltonien n’est autre que l’énergie du système et donc l’ensemble des états symétriques qu’on obtient (les vecteurs de la représentation irréductible) sont à énergie fixée.
Démonstration de l’orthonormalité
On est maintenant armé pour prouver l’orthonormalité des représentations irréductibles :
Soit $X$ une matrice $n_\mu \times n_\nu$ quelconque à partir de laquelle on forme :
$M_X=\sum_g D_\mu^{\dagger}(g) X D^\nu(g)$ où $D_\mu(g)$ (resp. $D_\nu(g)$) est une matrice de la représentation irréductible unitaires de $G$ d’ordre $\mu$ (resp. $\nu$). L’unitarité implique $D_\mu^{\dagger}(g)=D_\mu^{-1}(g)$.
En découle :
D’après le lemme de Schur, soit $\mu≠\nu$ (les deux représentations ne sont pas équivalentes) et alors $M_X = 0$, soit $\mu=\nu$ et $M_X=c_X E$ avec $c_X$ une constante (car on est dans le cas de l’automorphisme).
Choisissons $X$ parmi les $n_\mu \times n_\nu$ matrices $X_l^k\left(k=1, \cdots, n_\nu ; l=1, \cdots, n_\mu\right)$ dont les éléments sont définis par : $\left(X_l^k\right)^i_j=\delta_j^k \delta_l^i$.
Prenons un exemple pour fixer les idées, avec $n_\nu=4$ et $n_\mu=3$, $X^1_2$ s’écrit :
$\displaystyle X_2^1=\left(\begin{array}{llll} 0 & 0 & 0 & 0 \\ 1 & 0 & 0 & 0 \\ 0 & 0 & 0 & 0\\ \end{array}\right) $
Un seul élément de chaque $X^k_l$ est non nul (et vaut 1), celui se trouvant colonne $k$, ligne $l$.
On a alors :
$\left(M_l^k\right)^i_j=\sum_g D_\mu^{\dagger}(g)^i_m\left(X_l^k\right)^m_n D^\nu(g)^n_j=\sum_g D_\mu^{\dagger}(g)^i_l D^\nu(g)^k_j$ qui doit être nul dans le cas $\mu≠\nu$, expliquant le terme $\delta^\mu_\nu$ dans la relation à démontrer.
Et dans le cas $\mu=\nu$, $\left(M_l^k\right)^i_j=c_l^k \,\delta_j^i$ où les $c_k^l$ sont des constantes.
On détermine la valeur de ces constantes en prenant la trace de chacun des membres de l’équation ($i=j$) :
pour le membre de gauche, on obtient $n_\mu c_l^k$ et pour le membre de droite $\sum_g\left[D_\mu^{\dagger}(g) D^\mu(g)\right]_l^k=n_G \delta_l^k$.
Finalement, $c_l^k=\left(n_G / n_\mu\right) \delta_l^k$.
Remarque :
l’orthonormalité entre représentations irréductibles inéquivalentes est insuffisante pour obtenir la relation $\Sigma_\mu n_\mu^2=n_G$.
En effet, en considérant les $D^\mu(g)_j^i$, $g \in G$ comme un ensemble de vecteurs orthogonaux étiquetés par les $(\mu,i,j)$, on se retrouve avec $\Sigma_\mu n_\mu^2$ «vecteurs» dans cet ensemble puisque les $(i,j)$ prennent $n_\mu^2$ valeurs différentes et chacun de ces vecteurs est formé de $n_G$ composantes. Or le nombre de vecteurs mutuellement orthogonaux (donc linéairement indépendants) doit être au mieux égal à la dimension de l’espace vectoriel, ici $n_G$.
On a donc seulement $\sum_\mu n_\mu^2 \leq n_G$.
Cela rend néanmoins déjà possible la quête principale de la théorie des représentations : le recensement de toutes les représentations irréductibles non équivalentes d’un groupe donné.
Bien qu’anticipant la preuve, on sait déjà que l’inégalité est en réalité toujours saturée. Les «vecteurs» étiquetés par $(\mu,i,j)$ et formés de la collection ordonnée de $n_G$ $D^\mu(g)_j^i$, forment donc bien un ensemble complet en plus d’être orthogonal.
Applications de l’orthonormalité
Voyons maintenant comment utiliser l’orthogonalité pour construire de nouvelles représentations irréductibles.
$\mathrm{C}_2$, groupe le plus simple, a, comme tout les groupes, une représentations évidentes : l’identité $d_1$ définit comme $(e, a) \xrightarrow{d_1}(1,1)$ (notation signifiant $d_1(e)=1$ et $d_1(a)=1$). La notation réduite prend tout son sens avec la relation d’orthogonalité où les représentations sont vues comme des vecteurs). Si une deuxième représentation non équivalente $d_2$ est aussi regardé comme un vecteur a deux composantes, alors il doit être orthogonal à $(1,1)$. $(1,-1)$ est la seule possibilité à la fois orthogonale et normalisable. Donc le seul candidat pour une seconde représentation irréductible est $(e, a) \xrightarrow{d_2}(1,-1)$.
On ne peut trouver d’autres vecteurs orthogonaux, on a donc l’ensemble des représentation irréductibles de $\mathrm{C}_2$.
Partir de représentations simples comme l’identité est une des astuces.
Pour faire progresser l’investigation sur des groupes plus gros, on va avoir recours à une autre astuce liée aux groupes quotients mais cela va nous amener à digresser un peu…
Les groupes quotients fournissent de nouvelles représentations et permettent en outre de rendre fidèle une représentation dégénérée.
Représentations d’un groupe quotient :
Si un groupe $G$ a un sous-groupe invariant $H$ non trivial, alors toute représentation du groupe quotient $K=G/H$ est aussi une représentation de $G$, mais cette représentation de $G$ est dégénérée.
À l’inverse, si $U(G)$ est une représentation dégénérée de $G$, alors $G$ contient au moins un sous-groupe invariant $H$ tel que $U(G)$ définisse une représentation fidèle (non dégénérée) du groupe quotient $G/H$.
On a déjà vu que $\mathrm{S_3}$ a un sous-groupe invariant $H=\{e,(123),(321)\}$. Le groupe quotient est isomorphe à $\mathrm{C_2}=\{e,a\}$. Or $\mathrm{C_2} $ a une représentation assez simple $\{(e, a) \rightarrow(1,-1)\}$ (on reviendra plus loin sur ce type de notation et la méthode pour trouver une représentation autrement que par tâtonnement).
Cela induit une représentation unidimensionnelle de $\mathrm{S_3}$ associant $1$ aux éléments $\{e,(123),(321)\}$ et $-1$ à $\{(12),(23),(31)\}$. C’est effectivement une des possibilités trouvées dans l’exemple précédent en jouant avec la table de multiplication du groupe. Cette représentation, dégénérée pour $\mathrm{S_3}$, est bien une représentation fidèle pour $S_3 / H \simeq C_2$.
Remarque :
les représentations dégénérées et la manière de les rendre fidèle (ces choix sémantiques traduisent-ils une croisade morale de certains mathématiciens ?) reviendront sur le devant de la scène quand on parlera des groupes compacts (comme les rotations) et des topologies associées.
Ce nouvel outil peut faciliter grandement la recherche de représentations irréductibles comme on va le voir dans l’exemple suivant.
considérons le groupe dihédral $\mathrm{D_2}$ dont la table de multiplication est :
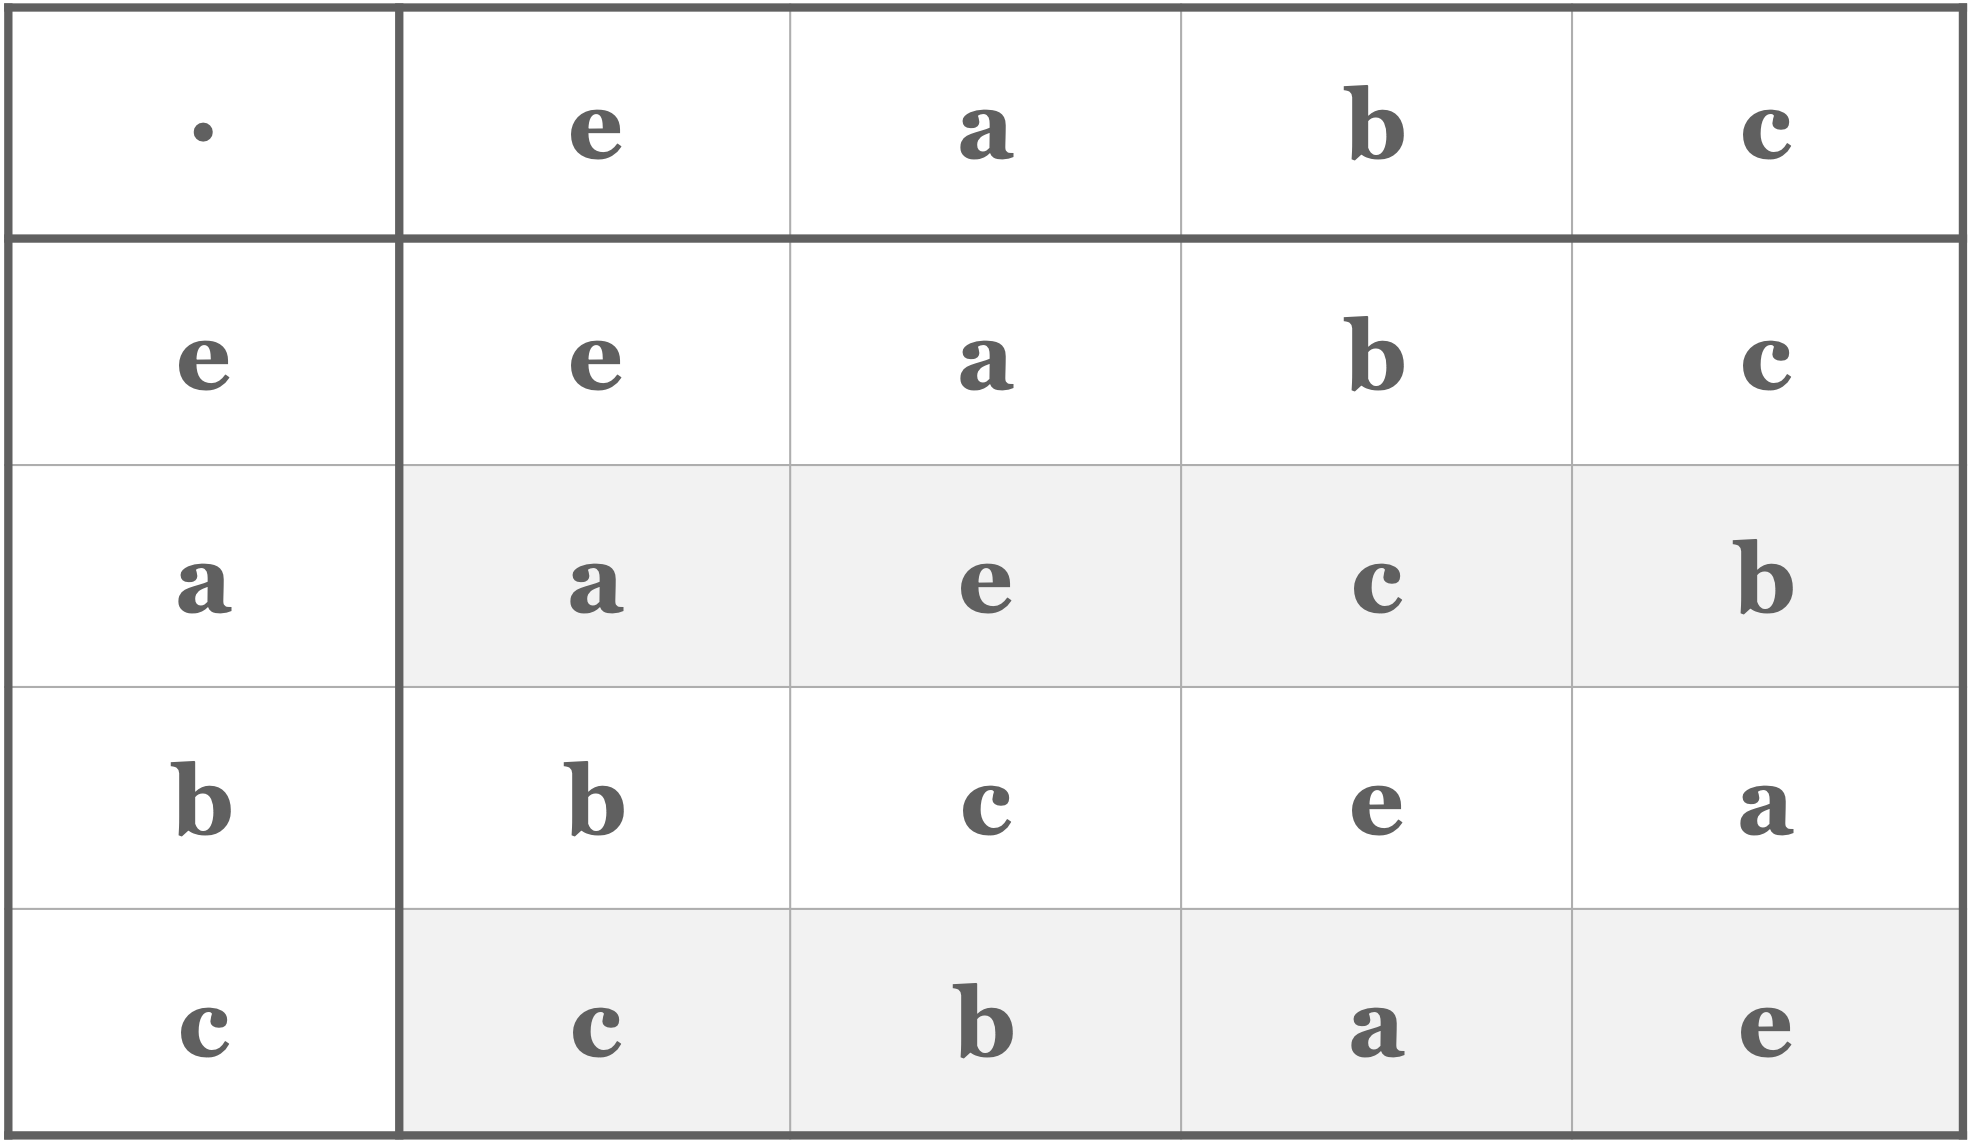
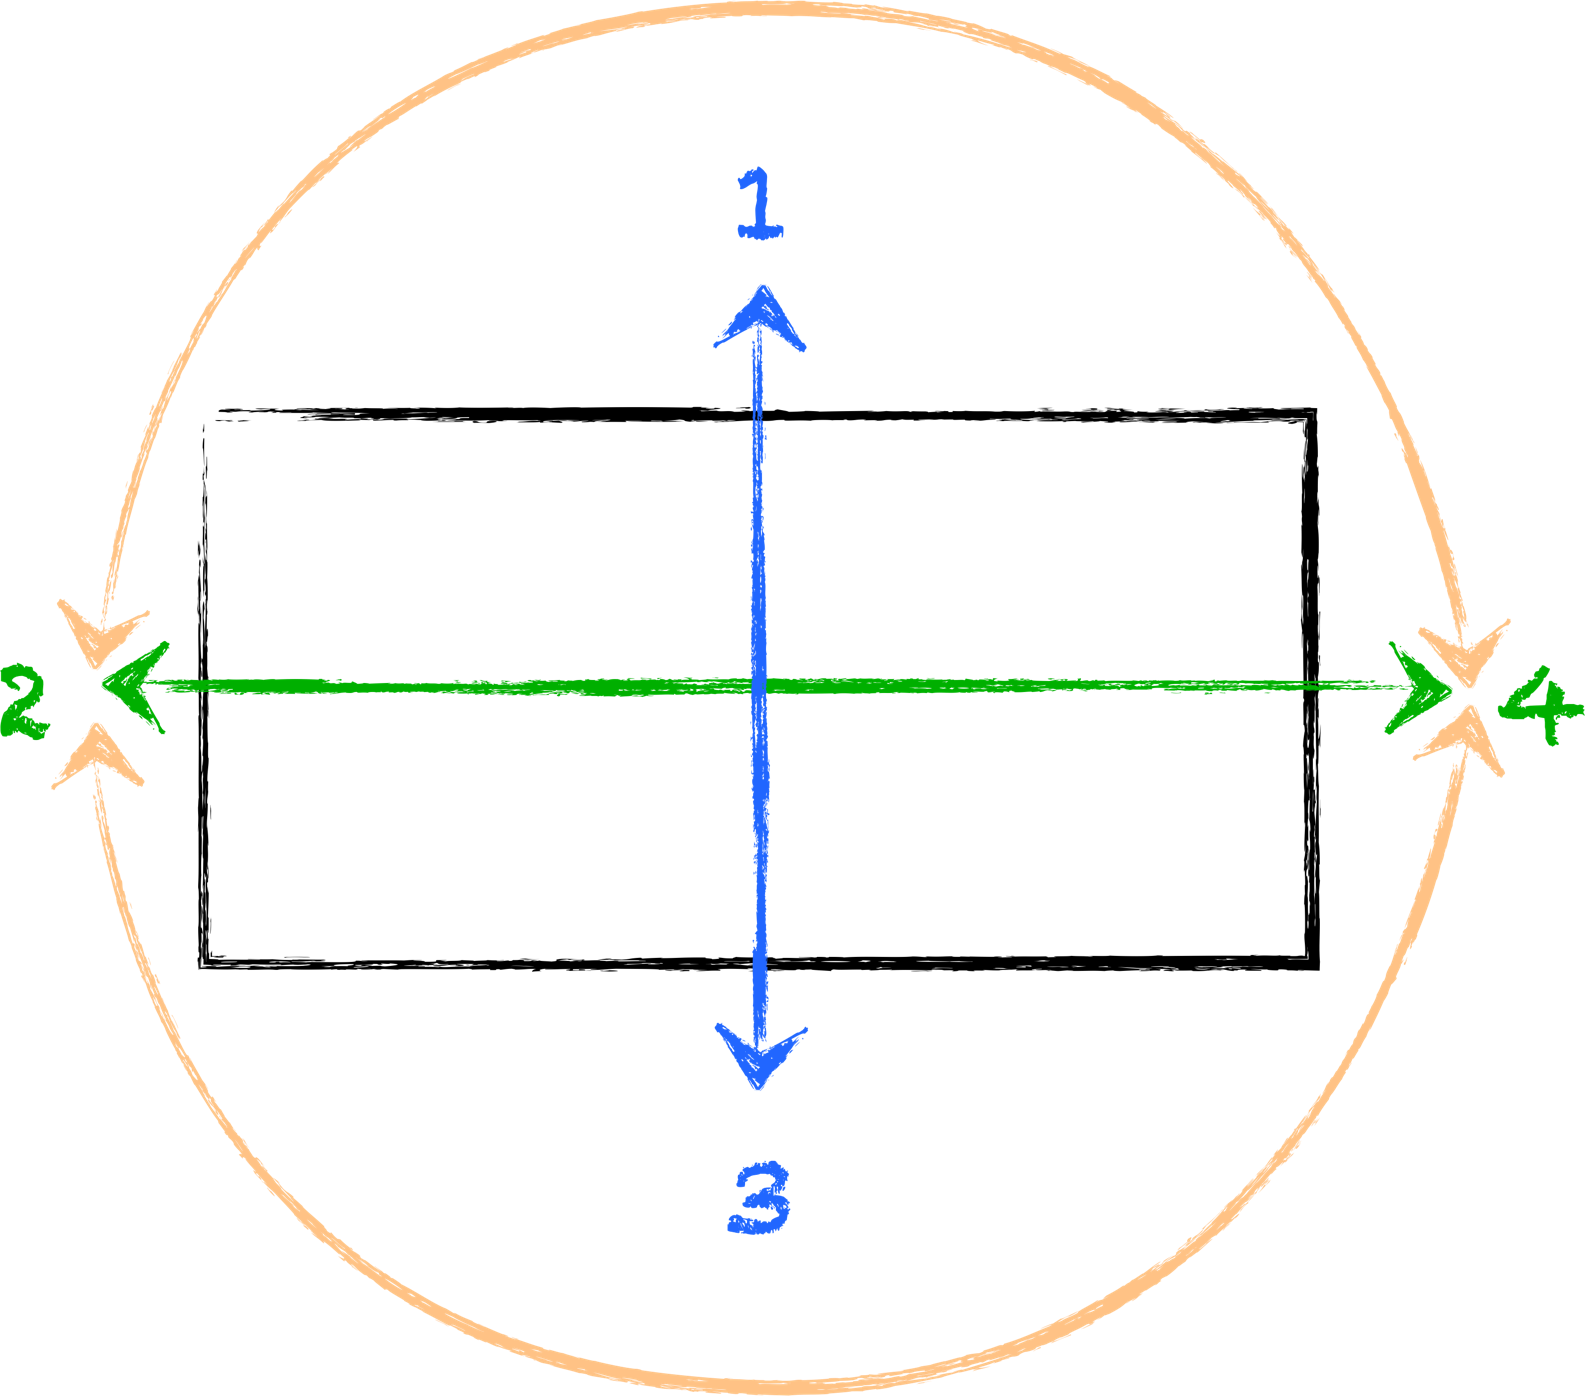
La première de ces représentations est la triviale identité : $(e, a, b, c) \xrightarrow{d_1}(1,1,1,1)$.
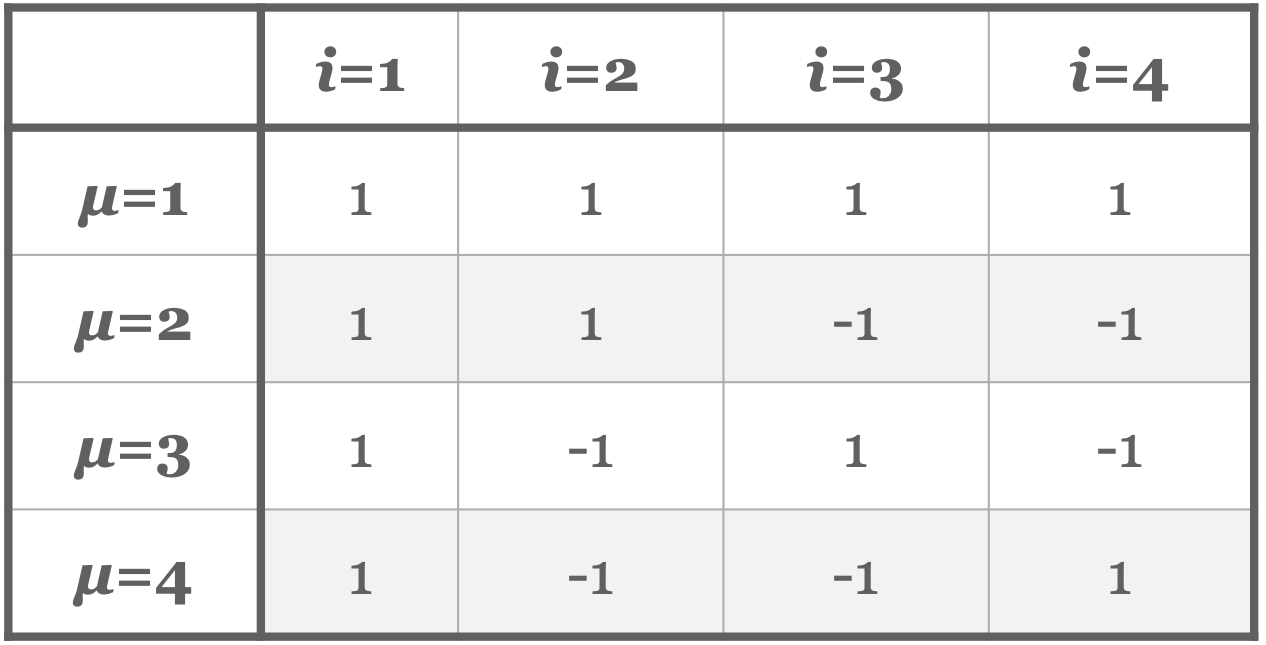
Maintenant, l’astuce : les éléments $\{e,a\}$ forment un sous-groupe invariant et le groupe quotient $\{\{e, a\},\{b, c\}\}$ est isomorphe à $\mathrm{C_2}$ (il n’y a qu’un groupe à deux éléments) dont on connait déjà les deux représentations irréductibles. Les deux représentations de $\mathrm{C_2}$ induisent deux représentations dégénérées sur $\mathrm{D_2}$. La première est la perpétuelle représentation identité, la deuxième associe $-1$ à $b$ et $c$ : $(e, a, b, c) \xrightarrow{d_2}(1,1,-1,-1)$.
On peut ensuite tenir le même raisonnement en partant du sous-groupe invariant $\{e,b\}$ qui nous amène la troisième représentation : $(e, a, b, c) \xrightarrow{d_3}(1,-1,1,-1)$.
Enfin, le sous-groupe invariant $\{e,c\}$ nous donne la quatrième et dernière : $(e, a, b, c) \xrightarrow{d_4}(1,-1,-1,1)$.
On vérifie bien que les 4 «vecteur» sont orthonornaux comme il se doit et qu’aucun autre ne peut exister par la même condition.
Remarques :
-
La relation $\Sigma_\mu n_\mu^2=n_G$ (que l’on démontrera plus loin) nous assure que pour tout groupe abélien (représentation unidimensionnelle $\Leftrightarrow n_\mu=1$), il y a autant de représentation que d’éléments ($n_G$) et les vecteurs formés par les représentations (étiquetés par $\mu$) forment alors un ensemble orthogonal complet.
Les représentations de $\mathrm{C_2}$ et $\mathrm{D_2}$ débusquées dans les exemples précédents illustrent bien ce point.
Plus besoin dans ce cas de guillemets au mot vecteur, il ne s’agit plus d’une collection pachydermique de $n_G$ objets de dimension $n_\mu^2$ mais bien d’une collection ordonnée de $n_G$ nombres qu’on désigne plus volontiers ainsi (ou des tenseurs de rang 1 si on veut fanfaronner), même si techniquement, les gros objets formés par une représentation quelconque peuvent tout autant revendiquer l’appellation. -
On s’intéressera dans les chapitres suivants à des groupes infinis et par chance, en dépit de quelques ajustements cosmétiques (les intégrales remplaceront les sommes discrètes), la condition d’orthonormalité des représentations irréductibles tient le choc.
Pour le groupe infini le plus simple, abélien et à une dimension, elle se confond avec le théorème de Fourier des fonctions périodiques et aiguise alors notre vision des choses ; la condition d’orthonormalité est en fin de compte une puissante extension du théorème de Fourier.
Comme on l’a déjà évoqué, les matrices des représentations dépendent de la base. Pour les représentations 1D des groupes abéliens, pas de soucis, mais chez les groupes plus complexes, les dimensions supplémentaires n’apporteront que tracas et confusion.
Grâce aux caractères, indépendants de la base, on pourrait maintenir un traitement équivalent aux douillettes représentations 1D quelle que soit la dimension. Transposer les relations d’orthonormalité chez les caractères, bien plus engageants, semble donc une entreprise judicieuse.
Conditions d’orthonormalité et de complétude pour les caractères irréductibles
Rappelons à toute fin utile que les caractères d’une représentation $U(G)$ sont les traces des opérateurs $U(g)$. Ils sont indépendant du choix de la base dans l’espace des représentations. Tous les éléments d’un groupe appartenant à une même classe ont par conséquent le même caractère dans une représentation donnée.
Soit $U^\mu(G)$ une représentation irréductible de $G$.
Alors la somme des $U^\mu(g)$ sur l’ensemble des éléments d’une classe donnée vaut :
$\displaystyle \sum_{h \in \zeta_i} U^\mu(h)=\frac{n_i}{n_\mu} \chi_i^\mu E $
où $\zeta_i$ est la classe $i$, $E$ l’opérateur identité, $n_\mu$ la dimension de la représentation et $n_i$ le nombre d’éléments dans la classe $i$.
Notons $A_i$ le membre de gauche de l’équation. On a alors $U^\mu(g) A_i U^\mu(g)^{-1}=A_i$ puisque le produit ne fait que réarranger l’ordre de la sommation (en utilisant le fait que si $h \in \zeta_i$, alors $g h g^{-1} \in \zeta_i$ pour tout $g\in G$). Donc $A_i$ commute avec toutes les représentations, ce qui, d’après le lemme de Schur, impose d’être proportionnel à l’opérateur identité : $A_i=c_i E$. On trouve $c_i$ en évaluant la trace des deux membres de l’équation. À gauche, ça donne $n_i \chi_i^\mu$, et à droite $c_i n_\mu$.
Ça va nous permettre de démontrer les relations d’orthonormalité et de complétude sur le groupe des caractères. Mais d’abord, énonçons-les…
Les caractères de représentations irréductibles non équivalentes d’un groupe $G$ satisfont les relations suivantes :
$$ \sum_i \frac{n_i}{n_G} \chi_\mu^{\dagger i} \chi_i^\nu=\delta_\mu^\nu \quad \text { orthonormalité } $$
$$ \frac{n_i}{n_G} \sum_\mu \chi_i^\mu \chi_\mu^{\dagger j}=\delta_i^j \quad \text { complétude } $$
où par convention $\chi_\mu^{\dagger i}=\left(\chi_i^\mu\right)^*$
Les $i$ courent sur les différentes classes du groupe et les $\mu$ sur les différentes représentations irréductibles non équivalentes.
On part de la condition d’orthonormalité des représentations irréductibles en imposant $i=k$ et $j=l$ pour obtenir les traces.
À gauche, on obtient :
$$ \left(n_\mu / n_G\right) \sum_g \chi_\mu^{\dagger}(g) \chi^\nu(g)=\left(n_\mu / n_G\right) \sum_i n_i \chi_\mu^{\dagger i}(g) \chi_i^\nu(g) $$
Et à droite, on obtient $n_\mu \delta_\mu^\nu$.
En simplifiant par $n_\mu$, il reste bien la condition d’orthonormalité annoncée : $\sum_i \frac{n_i}{n_G} \chi_\mu^{\dagger i} \chi_i^\nu=\delta_\mu^\nu$.
Partons maintenant de la relation de complétude entre représentations irréductibles :
$$ \sum_{\mu, l, k} \frac{n_\mu}{n_G} D^\mu(g)_k^l D_\mu^{\dagger}\left(g^{\prime}\right)^k_l=\delta_{g g^{\prime}} $$
et sommons les $g$ parmi les éléments de la classe $\zeta_i$, et les $g^\prime$ parmi les éléments de la classe $\zeta_j$ :
$$ \sum_{\mu, l, k} \frac{n_\mu}{n_G} \sum_{g \in \zeta_i} D^\mu(g)_k^l \sum_{g^{\prime} \in \zeta_j} D_\mu^{\dagger}\left(g^{\prime}\right)^k_l=\sum_{g \in \zeta_i} \sum_{g^{\prime} \in \zeta_j} \delta_{g g^{\prime}} $$
On obtient :
$$ \sum_{\mu, l, k} \frac{n_\mu}{n_G} \frac{n_i}{n_\mu} \chi_i^\mu E_k^l \frac{n_j}{n_\mu} \chi_\mu^{\dagger j} E_l^k=\sum_{\mu, l, k} \frac{n_i n_j}{n_\mu n_G} \chi_i^\mu \chi_\mu^{\dagger j} E_k^l E_l^k $$
Or $\sum_{l, k} E^l_k E^k_l=\sum_l E_l^l=\operatorname{Tr} E=n_\mu$. D’où :
$$ \sum_{\mu, l, k} \frac{n_\mu}{n_G} \frac{n_i}{n_\mu} \chi_i^\mu E_k^l \frac{n_j}{n_\mu} \chi_\mu^{\dagger j} E_l^k=\sum_\mu \frac{n_i n_j}{n_G} \chi_i^\mu \chi_\mu^{\dagger j} $$
En identifiant les deux membres, $\sum_\mu \frac{n_i n_j}{n_G} \chi_i^\mu \chi_\mu^{\dagger j}= n_j \delta_i^j$, et après simplification par $n_j$ on obtient bien la condition de complétude : $\frac{n_i}{n_G}\sum_\mu \chi_i^\mu \chi_\mu^{\dagger j}=\delta_i^j$.
On peut compactifier les relations en utilisant la règle de sommation implicite et en notant $\tilde{\chi}_i\equiv (n_i/n_G)^{1/2}\chi_i$ :
- $\tilde{\chi}^{\dagger i}_\mu \, \tilde{\chi}^\nu_i=\delta^\nu_\mu$
- $ \tilde{\chi}^\mu_i \, \tilde{\chi}^{\dagger j}_\mu=\delta^j_i$
Si on interprète les $\{\tilde{\chi}_i,i=1,2,\cdots,n_c \}$ comme les composantes d’un vecteur $\tilde{\chi}$ on peut encore simplifier la notation en :
où le $\cdot$ représente un produit scalaire dans l’espace vectoriel de dimension $n_c$.
On tire de ces relations sur les caractères une information très intéressante sur leurs grandes soeurs, les représentations irréductibles :
Le nombre de représentations irréductibles non équivalentes d’un groupe fini est égal aux nombre de classes distinctes de $G$ : $n_c$.
En effet, les relations précédentes montrent que les $\chi^\mu_i$ sont les éléments d’une matrice carrée de $\mu$ lignes et $i$ colonnes et comme les $i$ désignent les classes de conjugaison, au nombre de $n_c$, les $\mu$ varient aussi de 1 à $n_c$.
La matrice des caractères est donc $n_c\times n_c$. Mais en général, on préfère répertorier l’ensemble des caractères irréductibles d’un groupe $G$ donné dans un tableau, appelé table de caractères.
pour les groupes abéliens, chaque élément forme une classe à lui tout seul et toutes les représentations irréductibles sont unidimensionnelles. Donc $D^\mu(g)=\chi^\mu_i$.
Par conséquent les «vecteurs» $D^\mu(g)$ formés pour chaque $g$ dans les exemple de $\mathrm{C}_2$ et $\mathrm{D}_2$ constituent aussi les tables de caractère de ces groupes si on fait correspondre une classe $i$ à l’élément $g$ :
Table de caractères de $\mathrm{C_2}$
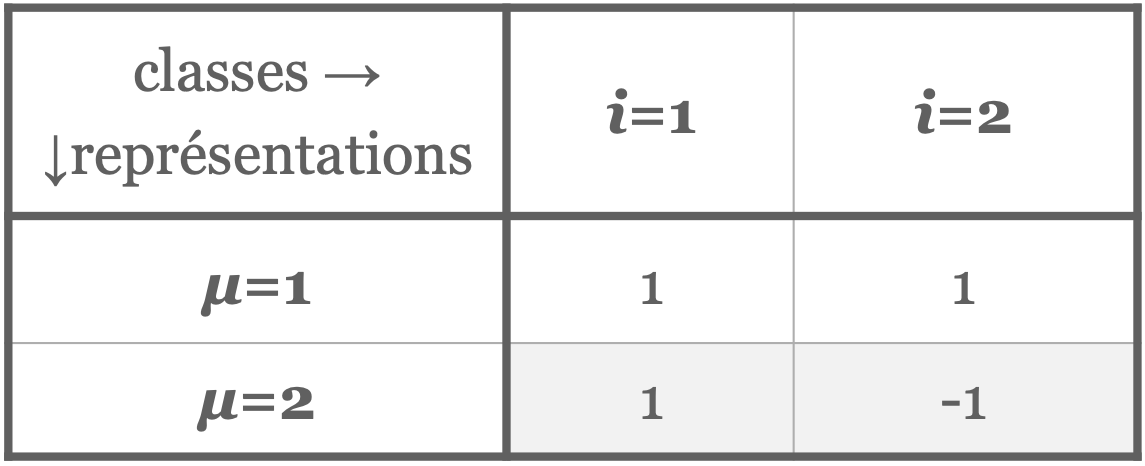
Table de caractères de $\mathrm{D_2}$
Les caractères $\chi^\mu_i$ sont beaucoup plus pratiques que les matrices $D^\mu (g)^k_{\;\,l}$ dans l’étude des représentations irréductibles d’un groupe (car plus simple et indépendants de la base).
Leur utilité est telle (spécialement en chimie pour l’étude des spectres et des orbitales moléculaires) que les tables de caractères de la plupart des groupes de symétrie ont été compilées et se retrouvent un peu partout (ici par exemple).
regardons ce que les caractères ont à nous dire sur notre exemple fil rouge, la molécule $\ce{NH3}$, ou de façon équivalente, le groupe $\mathrm{S_3}$.
$\mathrm{S_3}$ a 3 classes : le 1-cycle $\{e\}$, les 2-cycles $\{(12),(23),(31)\}$, et les 3-cycles $\{(123),(321)\}$. On doit donc avoir parallèlement 3 représentations irréductibles non équivalentes.
On en a déjà trouvé 2 sûres :
- la représentation triviale : $p\mapsto 1$ pour tout $p\in \mathrm{S_3}$. Attribuons-lui un beau $\mu =1$. Les 3 caractères sont $(1,1,1)$.
- on a aussi trouvé une autre représentation irréductible de dimension 1 ($\mu=2$), grâce aux groupes quotients, dans laquelle les permutations paires (1-cycle et 3-cycles) étaient envoyés sur 1 et les permutations impaires (2-cycle) sur -1. Ce qui donne comme caractère : $(1,-1,1)$.
La dernière représentation irréductible ($\mu=3$) doit être de dimension 2 d’après $\sum_\mu n_\mu^{\;2} = n_G$ donnant ici $n_G=6=1+1+{n_3}^2$ (relation qu’on a d’ailleurs toujours pas démontrée, patience…).
Pour déterminer les 3 $\chi_i^3$ on commence par $\chi_1^3 = \mbox{Tr }D(e)=\mbox{Tr }E=2$.
De $\tilde{\chi}^\dagger_1\cdot \tilde{\chi}^3 = 0$, on tire : $\frac{1}{6}\times 2+\frac{3}{6}\chi^3_2+\frac{2}{6}\chi^3_3 = 0$
Et de $\tilde{\chi}^\dagger_2\cdot \tilde{\chi}^3 = 0$ : $\frac{1}{6}\times 2-\frac{3}{6}\chi^3_2+\frac{2}{6}\chi^3_3 = 0$
Si on soustrait les deux égalités, on obtient $\chi_2^3 = 0$.
On en déduit $\chi_3^3 = -1$.
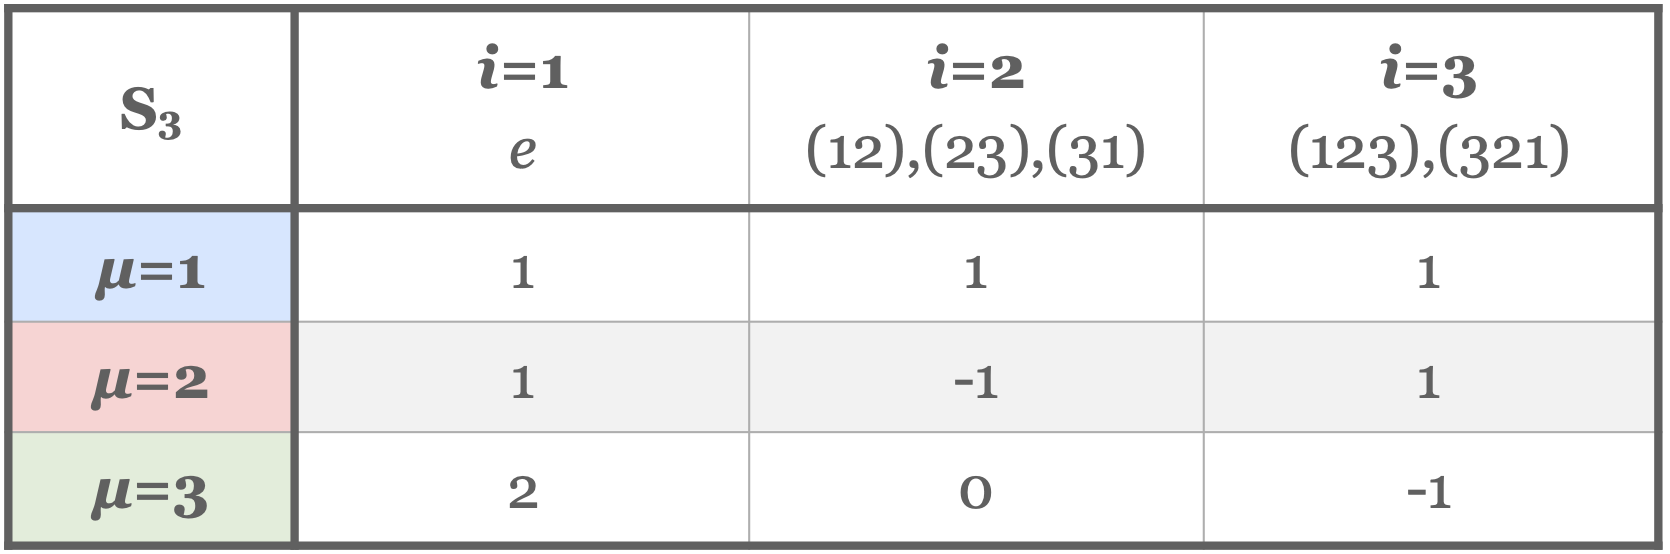
On peut vérifier alors qu’on a bien $\tilde{\chi}^\dagger_3\cdot \tilde{\chi}^3 = \frac{1}{6}\times 4+0+\frac{2}{6}\times1=1$ et que les relations de complétude sont elles-aussi bien respectées.
Remarques :
- Les conditions d’orthonormalité correspondent aux produits scalaires entre les lignes de la table (les représentations) alors que les conditions de complétude correspondent aux produits scalaires entre les colonnes (les classes). Il n’y a pas de différence technique entre les deux ensembles de relations : le passage aux caractères les a symétrisées, si bien qu’être complet sur les représentations revient à être orthogonal sur les classes, et inversement.
- La dimension de toute représentation est donnée par le caractère de l’élément neutre (la représentation de l’élément neutre est toujours une matrice identité, et sa trace donne donc sa dimension). Or par convention, $e$ correspond à la première classe, placée en première colonne : la première colonne d’une table de caractères donne donc la dimension de chacune des représentations irréductibles du groupe.
Pour $\mathrm{S_3}$, on a bien deux représentations de dimension 1, déjà déterminées, et une troisième représentation irréductible, cette fois-ci de dimension 2. Les matrices $2\times 2$ décrivant les éléments du groupe $\mathrm{D_3}$ dans l’exemple introductif de la molécule $\ce{NH3}$ étaient donc, semble-t-il, un bon candidat comme représentation irréductible (on va y revenir).
Combien de fois chaque représentation irréductible apparaît-elle ?
On sait déjà qu’une représentation se décompose en une somme directe de composantes irréductibles :
$U(G)=\sum_{\mu \oplus} a_\mu U^\mu(g)$
Et grâce aux relations précédentes, on connaît pas mal de choses sur cette décomposition : nombre de morceaux différents, dimensions… Mais il reste une inconnue majeure : combien de fois une représentation irréductible donnée apparaît-elle dans la combinaison linéaire ? Plus prosaïquement, que valent les $a_\mu$ ?
C’est là que les caractères abattent leur atout maître :
Dans la réduction d’une représentation $U(G)$ d’un groupe $G$ en ses composantes irréductibles, le nombre de fois ($a_\nu$) qu’une représentation irréductible $U^\nu(G)$ apparaît est donné par :
$\displaystyle a_\nu=\sum_i \frac{n_i}{n_G} \chi_\nu^{\dagger i} \chi_i=\tilde{\chi}_\nu^{\dagger} \cdot \tilde{\chi} $
Prenons la trace de $U(G)=\sum_{\mu \oplus} a_\mu U^\mu(g)$. On obtient $\chi_i=\sum_\mu a_\mu \chi_i^\mu$.
Après multiplication par $\left(n_i / n_G\right)^{1 / 2}$ : $\tilde{\chi}_i=\sum_\mu a_\mu \tilde{\chi}_i^\mu$.
Si on prend le produit scalaire par $\tilde{\chi}_\nu^{\dagger i}$ de chaque côté :
$\displaystyle \tilde{\chi}_\nu^{\dagger i} \tilde{\chi}_i=\tilde{\chi}_\nu^{\dagger} \cdot \tilde{\chi}=\sum_\mu a_\mu \tilde{\chi}_\nu^{\dagger i} \tilde{\chi}_i^\mu=\sum_\mu a_\mu\, \tilde{\chi}_\nu^{\dagger} \cdot \tilde{\chi}^\mu=\sum_\mu a_\mu \delta_\nu^\mu=a_\nu $
Une représentation matricielle 2D du groupe $\mathrm{C_2}$ peut ressembler à ça :
$e \rightarrow\left(\begin{array}{ll} 1 & 0 \\ 0 & 1 \end{array}\right)$ , $a \rightarrow\left(\begin{array}{ll} 0 & 1 \\ 1 & 0 \end{array}\right)$
Les caractères de cette représentation sont $\chi=(2,0)$.
La table de caractères de $\mathrm{C_2}$ nous donne de son côté $\chi^{\mu=1}=(1,1)$ et $\chi^{\mu=2}=(1,-1)$.
Donc d’après le théorème précédent : $a_1=\frac{1}{2}(1\times 2)+\frac{1}{2}(1\times 0)=1$ et $a_2=\frac{1}{2}(1\times 2)+\frac{1}{2}((-1)\times 0)=1$, ce qui signifie que chacune des deux représentations irréductibles apparaît une fois dans la réduction de la représentation bidimensionnelle.
Prouvons-le en diagonalisant $D(a)$.
Le polynôme caractéristique s’écrit $\operatorname{Det}(D(a)-x E)=0 \Leftrightarrow x^2-1=0$, d’où $\pm 1$ comme valeurs propres, ce qui implique :
$D^{\prime}(a)=\left(\begin{array}{cc} 1 & 0 \\ 0 & -1 \end{array}\right)=S\left(\begin{array}{ll} 0 & 1 \\ 1 & 0 \end{array}\right) S^{-1}$
et $D^{\prime}(e)=S D(e) S^{-1}=S E S^{-1}=E$.
La représentation matricielle $D(G)$ est donc équivalente à $D^{\prime}(G)$ définie par :
$e \rightarrow\left(\begin{array}{ll} 1 & 0 \\ 0 & 1 \end{array}\right)$ , $a \rightarrow\left(\begin{array}{cc} 1 & 0 \\ 0 & -1 \end{array}\right)$
Et il n’est pas trop dur de voir que $D^{\prime}(G)$ s’écrit effectivement comme la somme directe des deux représentations irréductibles de $\mathrm{C_2}$.
Les caractères nous donnent aussi une condition nécessaire et suffisante pour affirmer qu’une représentation $U(G)$ de caractères $\{\chi_i\}$ est bien irréductible :
$\displaystyle \sum_i n_i\left|\chi_i\right|^2=n_G \quad$ soit encore $\displaystyle \quad \tilde{\chi}=1 $
Soit $a_\mu$ le nombre de fois que la représentation irréductible $U^\mu(G)$ est contenue dans $U(G)$ :
$\displaystyle \tilde{\chi}^{\dagger} \cdot \tilde{\chi}=\left(a_\mu \tilde{\chi}^\mu\right)^{\dagger} \cdot\left(a_\nu \tilde{\chi}^\nu\right)=a_\mu^* a_\nu\, \tilde{\chi}_\mu^{\dagger} \cdot \tilde{\chi}^\nu=a_\mu^* a_\nu \delta_\mu^\nu=\sum_\mu\left|a_\mu\right|^2 $
Si $U(G)$ est équivalente à une représentation irréductible $U^\nu(G)$, alors $a_\nu=1$ et $a_\mu=0$ pour $\mu \neq \nu$, et donc $\tilde{\chi}^{\dagger} \cdot \tilde{\chi}=1$.
Réciproquement, si $\tilde{\chi}^{\dagger} \cdot \tilde{\chi}=1$, alors $\sum_\mu\left|a_\mu\right|^2=1$ et la seule possibilité (les $a_\mu$ valant $0,1,2,\ldots$) est d’avoir $a_\nu=1$ pour un certain $\nu$ et $a_\mu=0$ pour $\mu \neq \nu$.
Montrons que la représentation 2D de $\mathrm{S_3}$ ($\mu=3$) est bien irréductible :
$n_1 \chi_1{ }^2+n_2 \chi_2{ }^2+n_3 \chi_3{ }^2=1 \times 2^2+3 \times 0+2 \times(-1)^2=6=n_G$
Terminons par la dernière représentation non disséquée de l’exemple introductif sur la molécule $\ce{NH3}$, celle correspondant à la permutation des orbitales par les éléments du groupe. Les caractères associés sont $\chi=(4,2,1)$.
On peut d’abord vérifier la réductibilité : $1 \times 4^2+3 \times 2^2+2 \times 1^2=30 \neq 6$.
Ensuite, on peut chercher combien de fois chacune des 3 représentations irréductibles du groupe se trouve dans cette représentation :
$$ \begin{aligned} a_1 & =\frac{1}{6} \times 1 \times 4+\frac{3}{6} \times 1 \times 2+\frac{2}{6} \times 1 \times 1=2 \\ a_2 & =\frac{1}{6} \times 1 \times 4+\frac{3}{6} \times(-1) \times 2+\frac{2}{6} \times 1 \times 1=0 \\ a_3 & =\frac{1}{6} \times 2 \times 4+\frac{3}{6} \times 0 \times 2+\frac{2}{6} \times(-1) \times 1=1 \end{aligned} $$
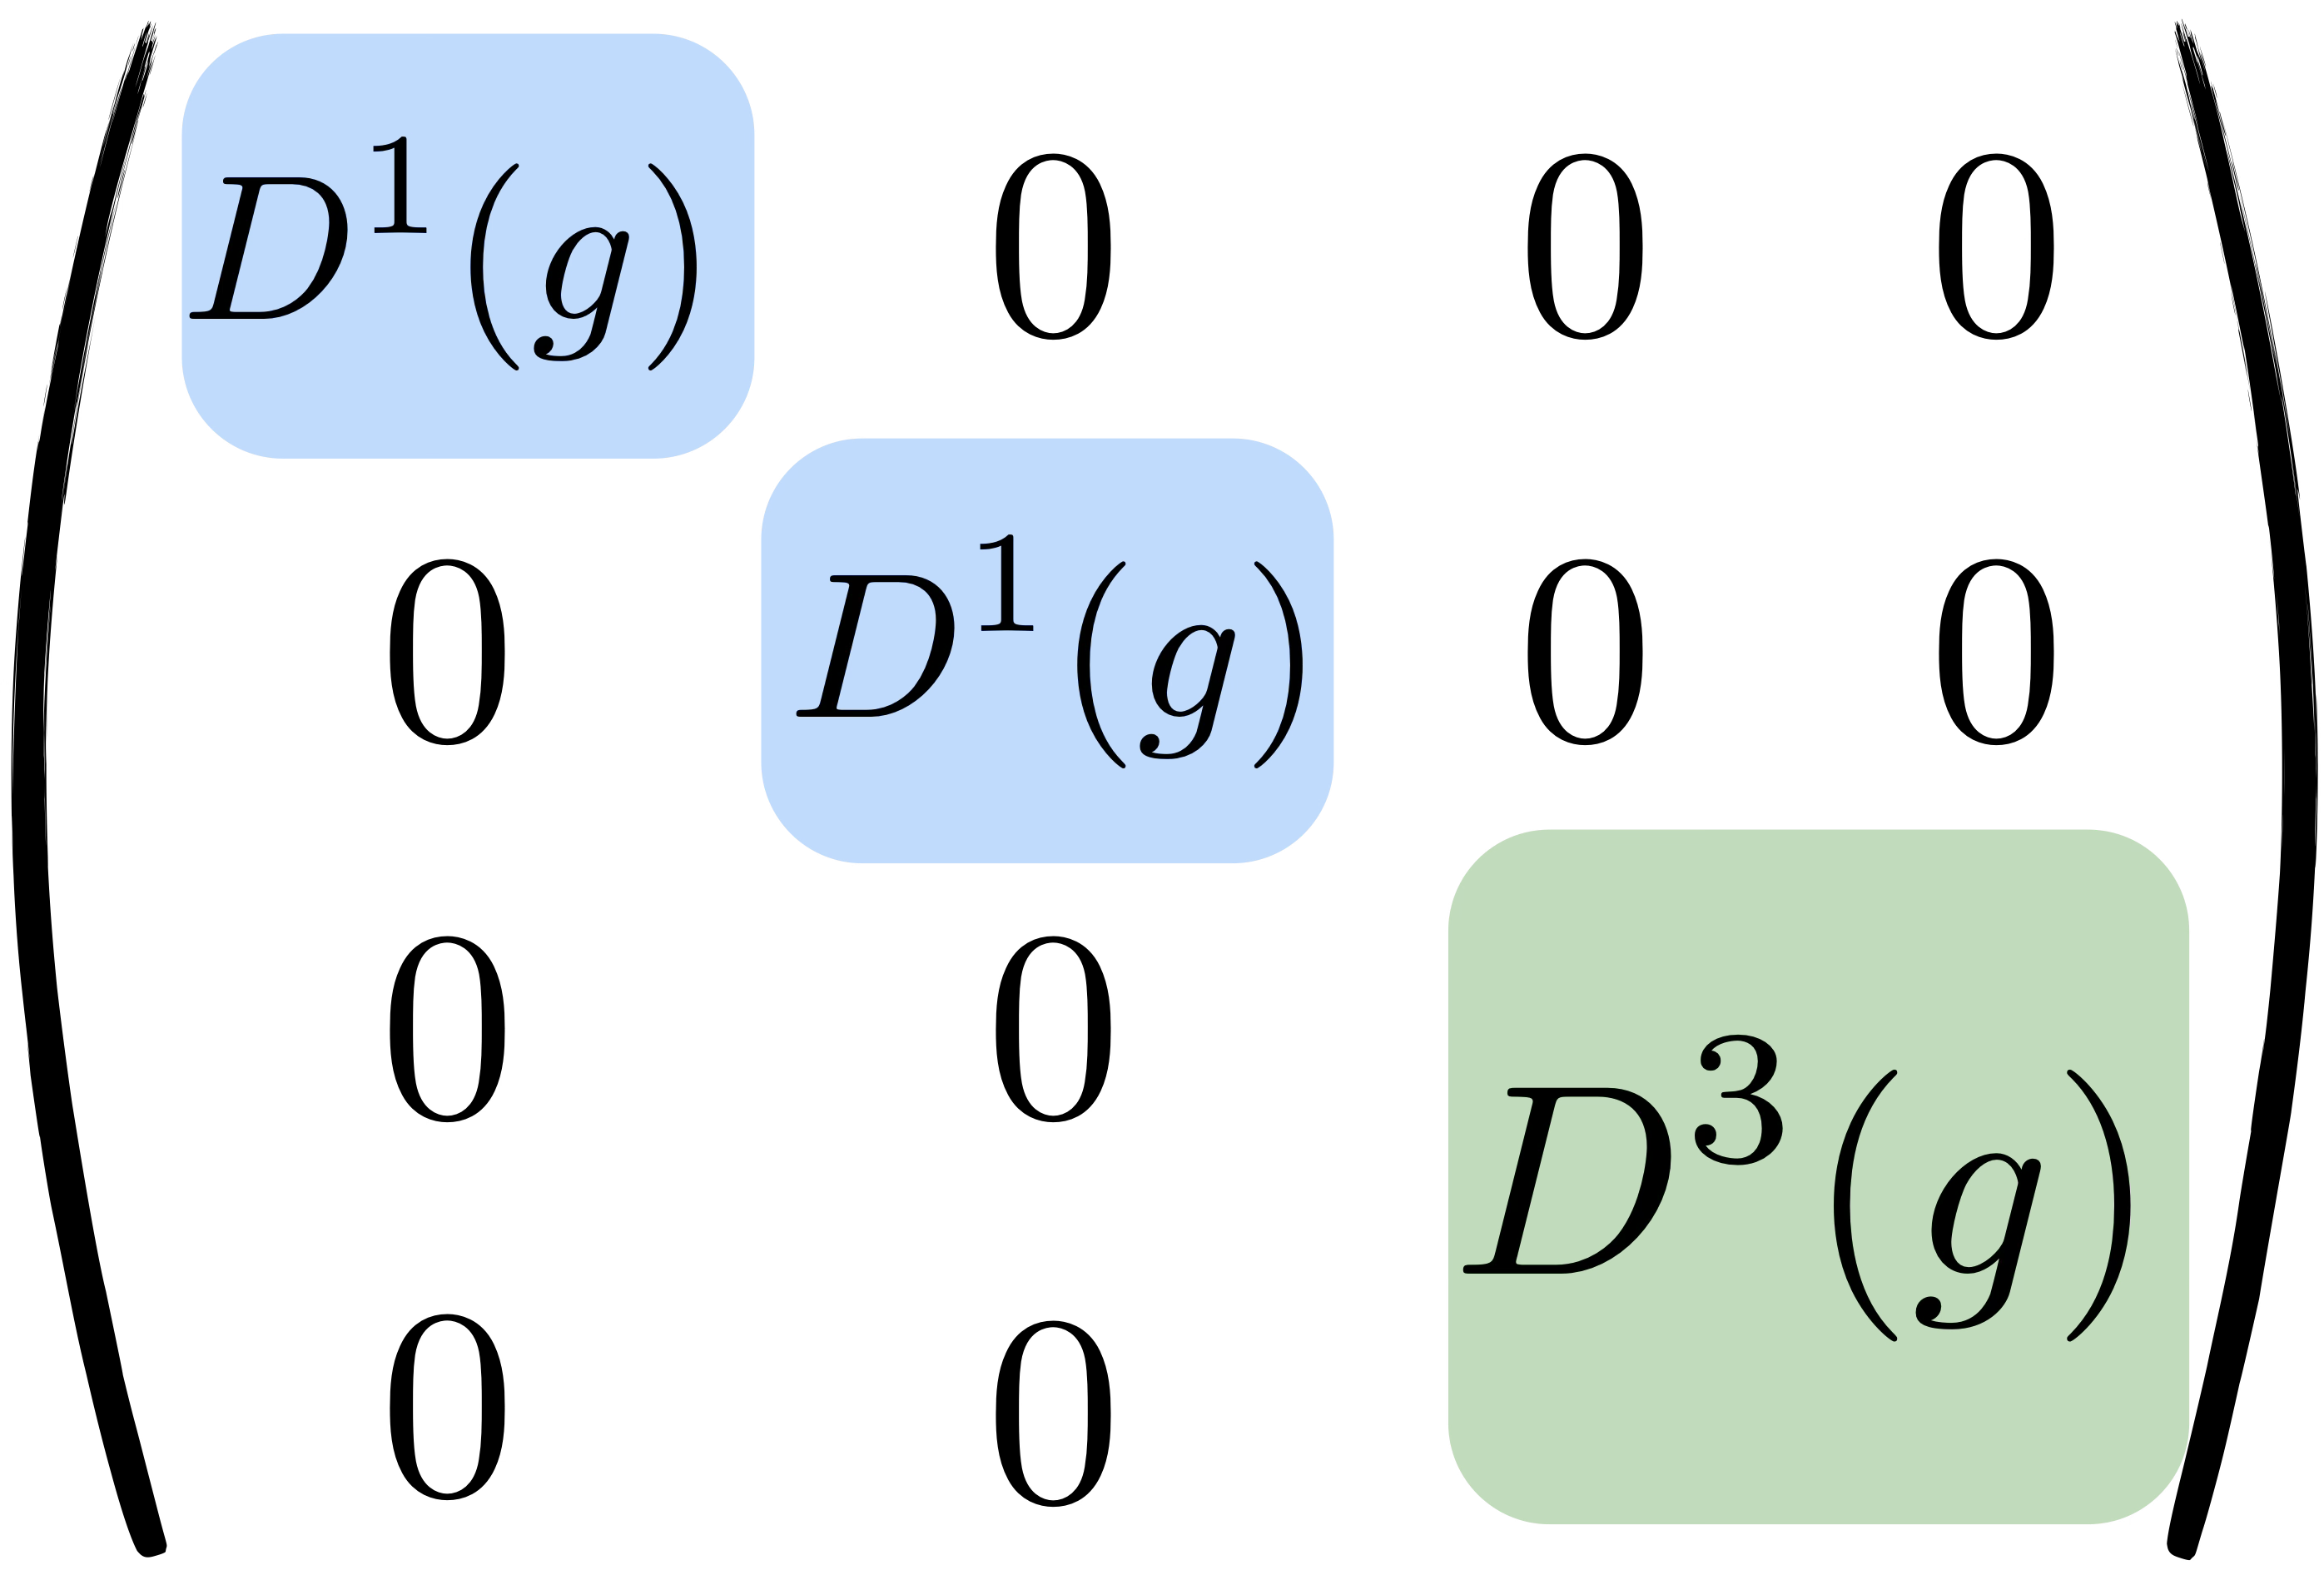
Donc on trouve 2 fois la représentation triviale, aucune fois la deuxième et une fois la troisième (celle de dimension 2).
On peut enfin tenter la diagonalisation par bloc des matrices, pour voir si ça confirme nos prévisions : le travail est déjà amorcé puisqu’un petit 1 s’ennuie en haut à gauche des 6 matrices. C’est l’orbitale de l’azote, qui n’est modifiée par aucune des transformations. On a notre première représentation triviale.
Restent 6 matrices $3\times 3$. Comme on suspecte une autre représentation triviale de dimension 1, on cherche s’il existe une combinaison des 3 orbitales laissée invariante. On voit vite que le vecteur $(1,1,1)$ est vecteur propre de chacune des 6 matrices (ou $s_1+s_2+s_3$, somme des 3 orbitales, pour reprendre les notations de l’exemple) pour la valeur propre 1.
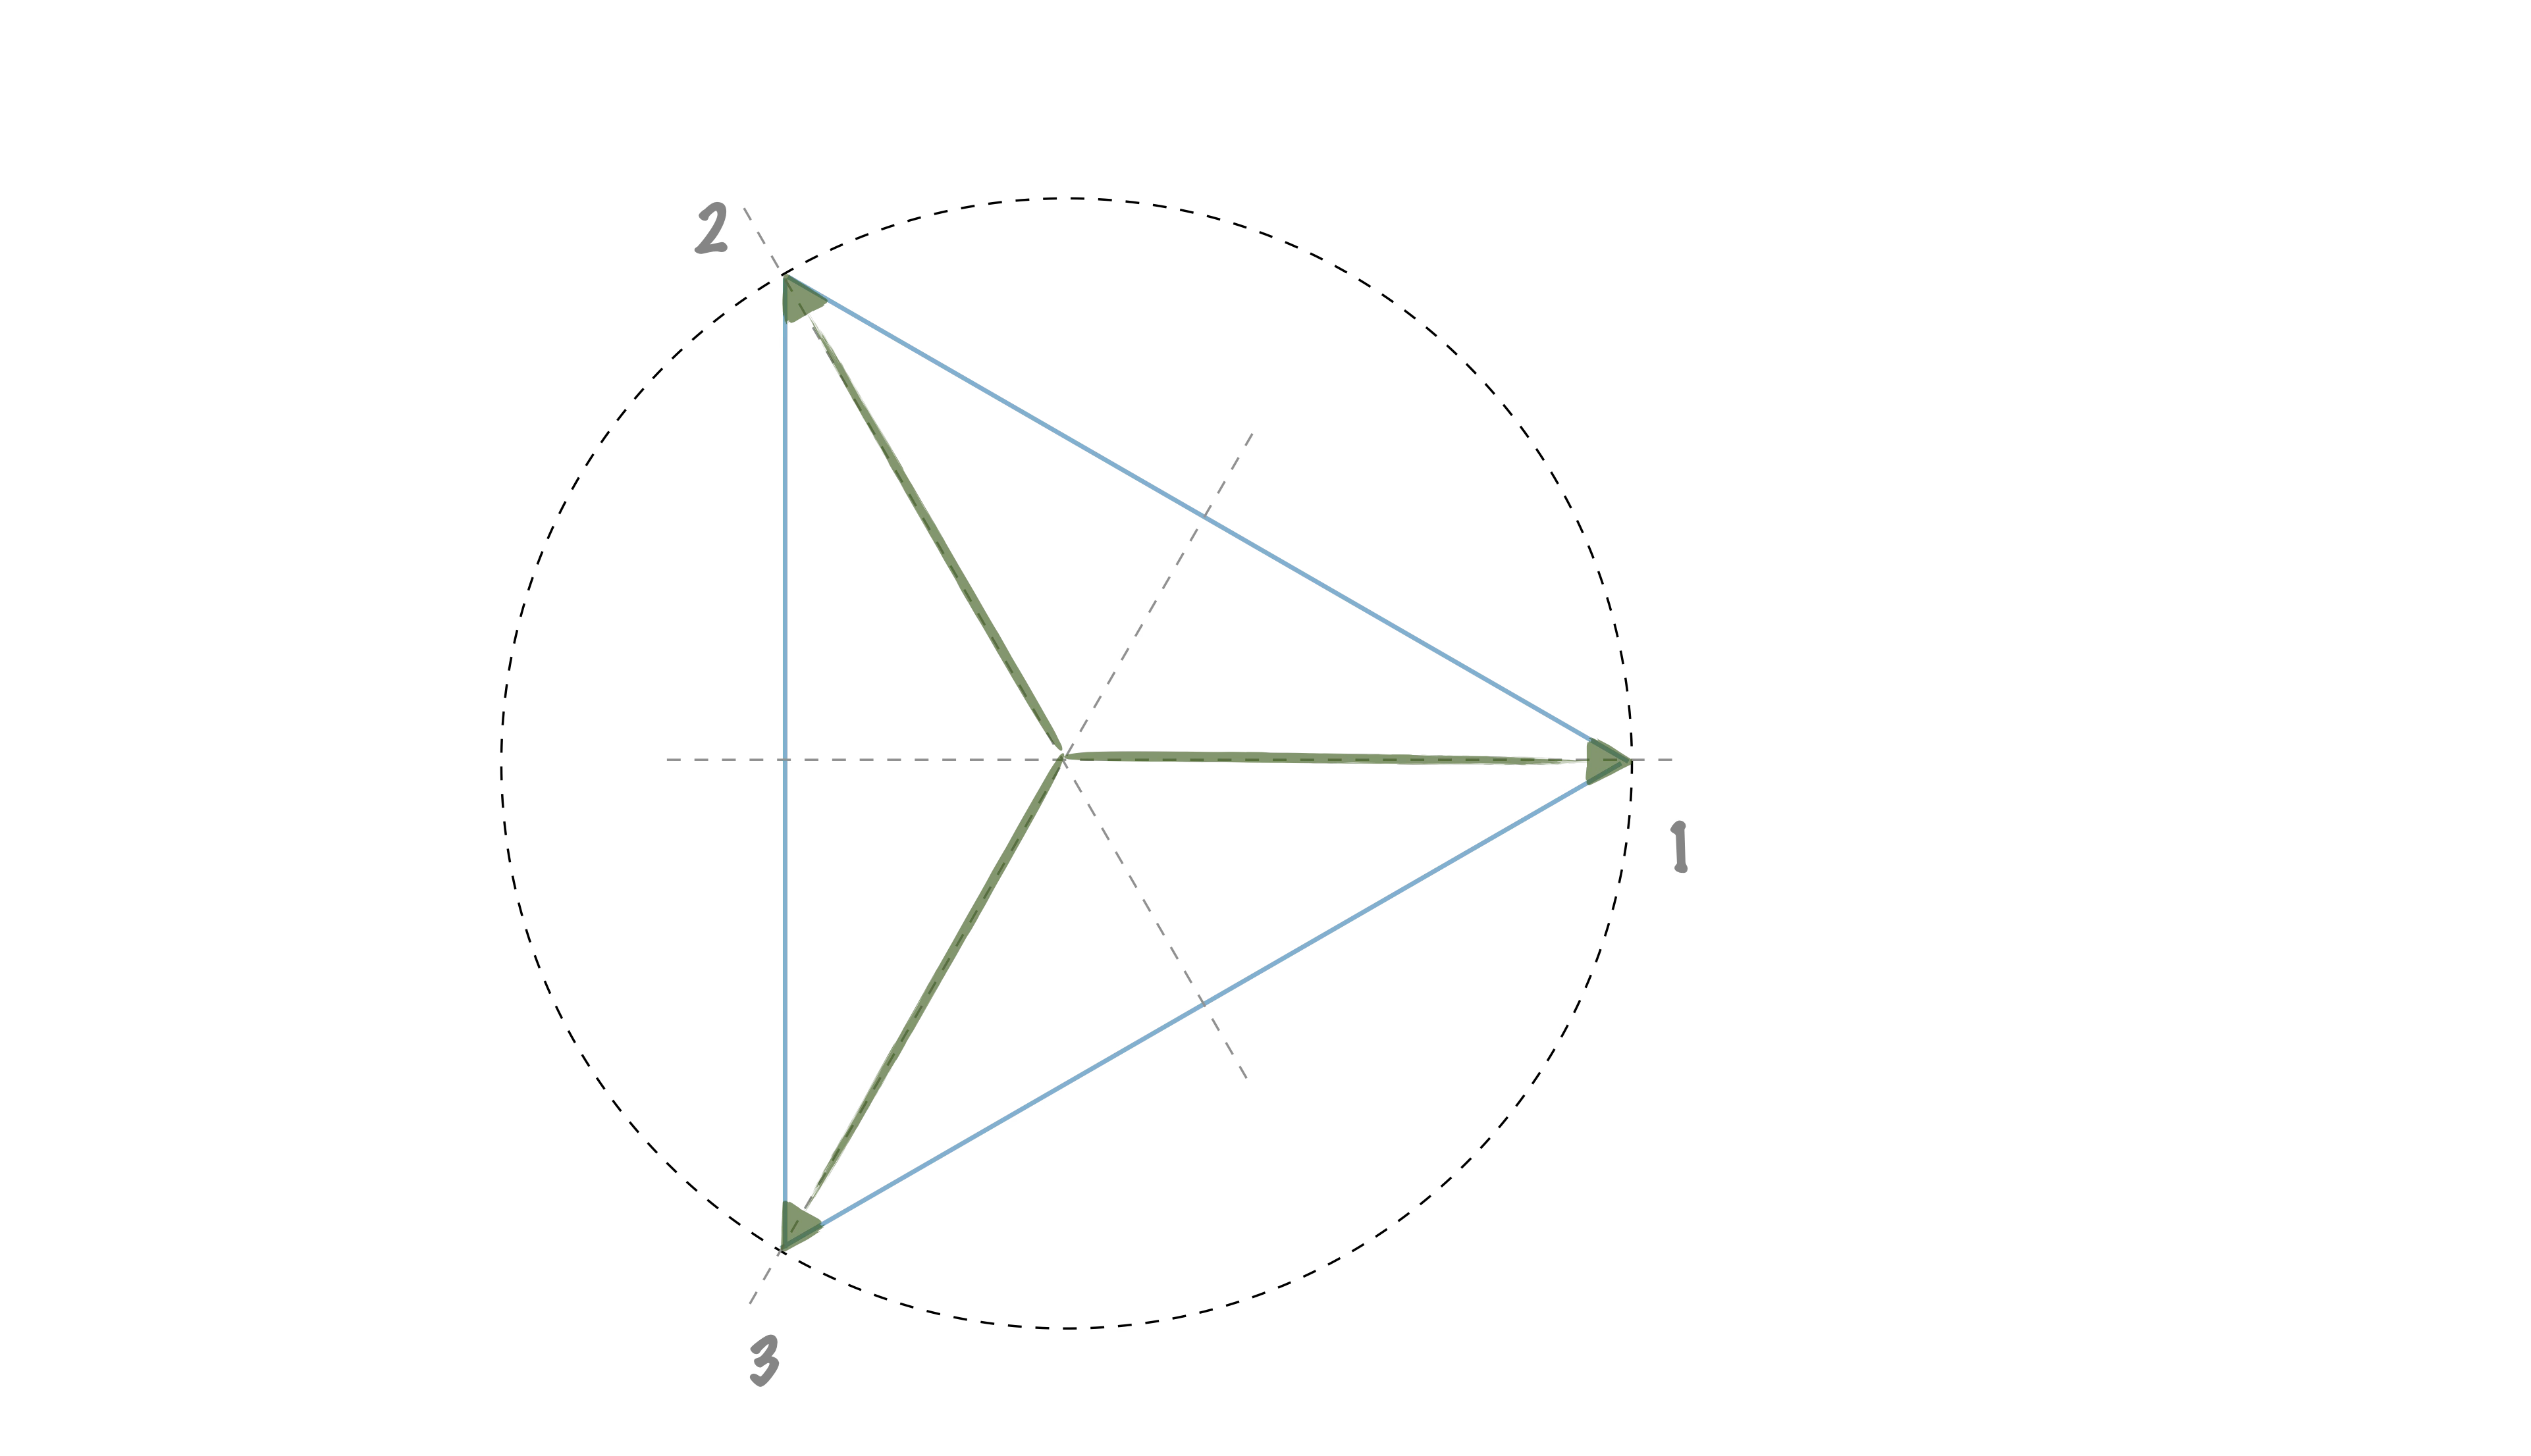
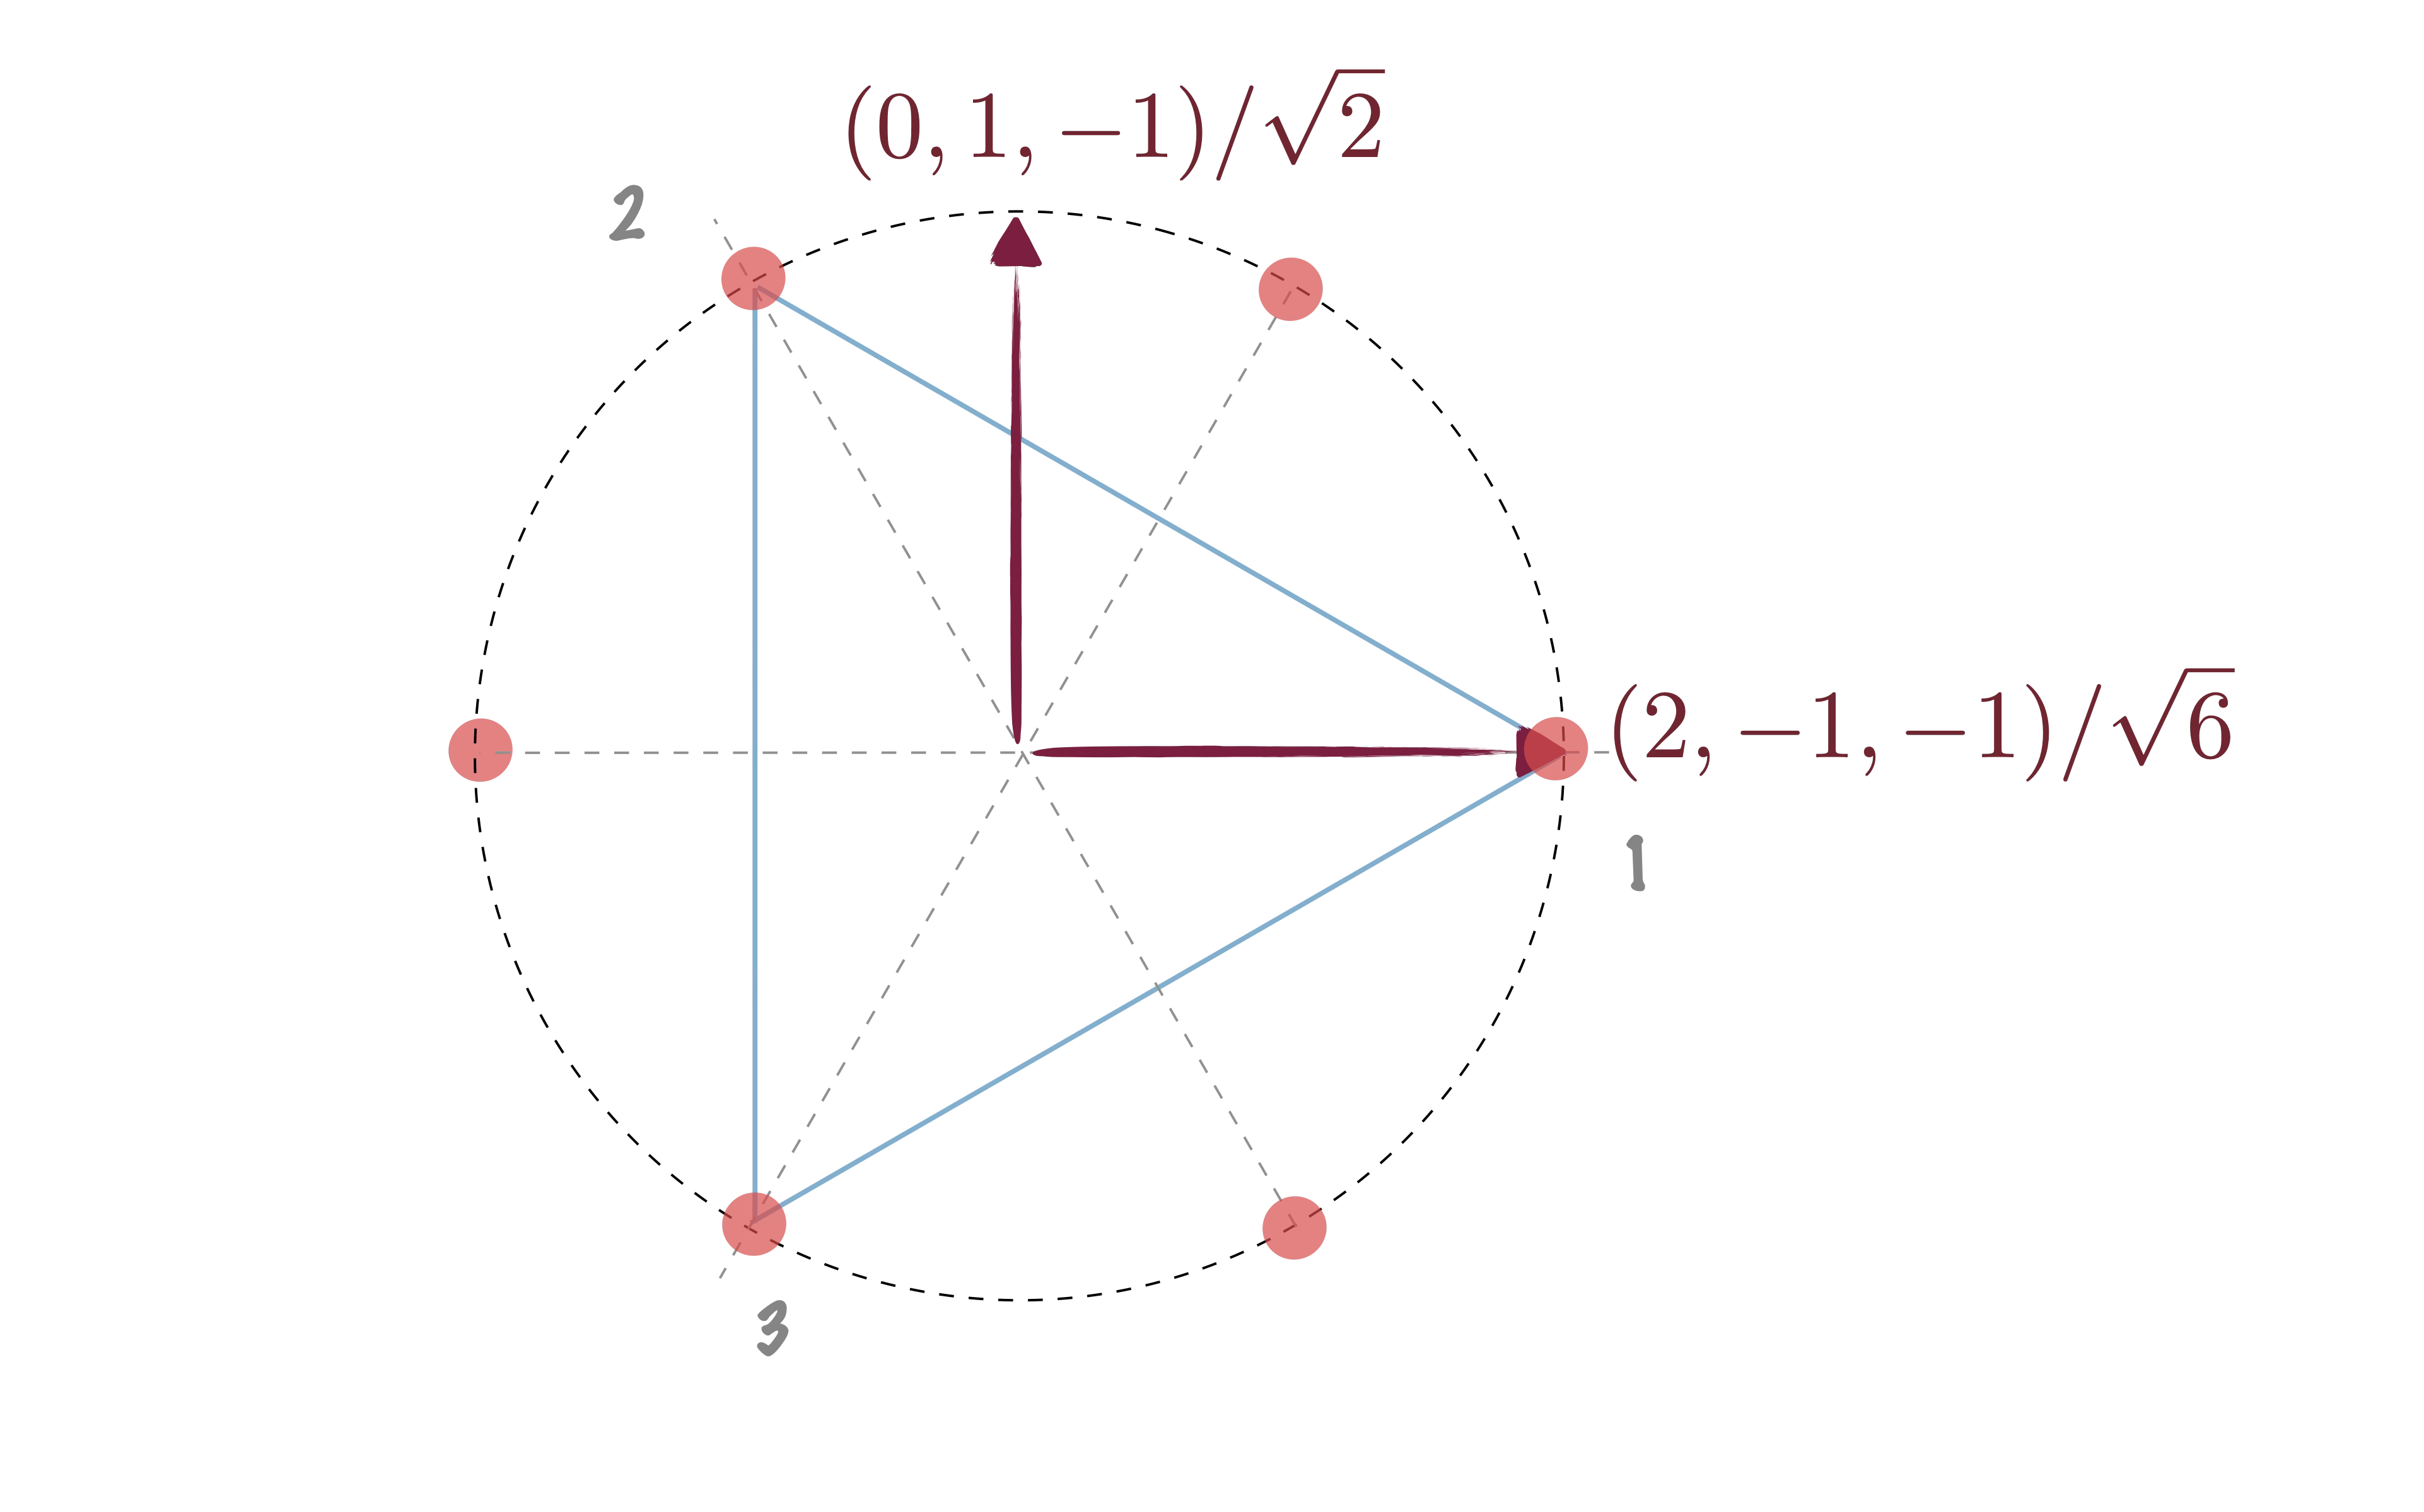
Nous voilà finalement avec un bloc 2D laissé stable dans le plan orthogonal à $(s_1+s_2+s_3)$, porté par les directions $(2 s_1-s_2-s_3)$ et $(s_2-s_3)$, donnant après normalisation les 2 vecteurs de base $\frac{1}{\sqrt{6}}(2,-1,-1)$ et $\frac{1}{\sqrt{2}}(0,1,-1)$.
La base de départ est formée des 3 orbitales $(s_1,s_2,s_3)$, ce qui correspond, sur une représentation 2D, à 3 vecteurs ayant pour origine le centre du triangle et pointant vers les 3 sommets :
La nouvelle base orthonormée correspond alors à :
On peut maintenant finir d’écrire le dernier bloc $2\times 2$ des matrices de la représentation, ce qui donne au final :
- pour l’élément neutre :
$$ \left(\begin{array}{cccc} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{array}\right) $$
- pour les 3 réflexions d’axe passant respectivement par les sommets 1, 2 et 3 :
$$ \left(\begin{array}{cccc} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & -1 \end{array}\right), \left(\begin{array}{cccc} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & -\frac{1}{2} & -\frac{\sqrt{3}}{2} \\ 0 & 0 & -\frac{\sqrt{3}}{2} & \frac{1}{2} \end{array}\right), \left(\begin{array}{cccc} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & -\frac{1}{2} & \frac{\sqrt{3}}{2} \\ 0 & 0 & \frac{\sqrt{3}}{2} & \frac{1}{2} \end{array}\right) $$
- et enfin pour les 2 rotations ($+2\pi/3$ et $-2\pi/3$) :
$$ \left(\begin{array}{cccc} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & -\frac{1}{2} & -\frac{\sqrt{3}}{2} \\ 0 & 0 & \frac{\sqrt{3}}{2} & -\frac{1}{2} \end{array}\right), \left(\begin{array}{cccc} 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & -\frac{1}{2} & \frac{\sqrt{3}}{2} \\ 0 & 0 & -\frac{\sqrt{3}}{2} & -\frac{1}{2} \end{array}\right) $$
On retrouve la représentation 2D donnée dans l’exemple introductif et on peut vérifier, grâce à ses caractères $\chi=(2,0,-1)$, qu’elle est bien semblable à la représentation irréductible $\mu=3$.
Conclusion, on a bien la décomposition attendue :
Remarquons que la deuxième représentation, absente de cette décomposition, peut s’obtenir en prenant les déterminants des 6 matrices (ça donne bien $1$ pour l’élément neutre et les rotations, et $-1$ pour les permutations deux à deux).
C’est général : le déterminant des matrices associées à une représentation forme aussi une représentation (unidimensionnelle). Remercions pour cela le déterminant de conserver l’action de groupe : $\operatorname{det} A B=\operatorname{det} A \times \operatorname{det} B$.
La représentation régulière
La représentation du dernier exemple, partant d’une base formée d’éléments géométriques du groupe (les orbitales des hydrogènes sont les sommets du triangle équilatéral et celle de l’azote peut être vue comme son centre), semble assez naturelle et donne l’idée d’une autre représentation, encore plus naturelle, mère de toutes les représentations en quelque sorte.
Elle consiste à utiliser les éléments mêmes du groupe comme base. Chacune des matrices, de dimension $n_G$, décrit alors les permutations que subit l’ensemble des éléments du groupe sous l’action d’un élément donné. On l’appelle représentation régulière : elle reproduit, en l’éclatant, la table de multiplication du groupe (élément par élément). Elle va nous permettre d’enfin démontrer la complétude des représentations irréductibles.
Soit $G$ un groupe fini d’éléments $\{g_i, i=1, \cdots, n_G\}$. La loi de composition interne du groupe, $g_i g_j=g_k$, peut se réécrire formellement :
$\displaystyle g_i g_j=g_m \Delta_{i j}^m \quad$ où $\displaystyle \Delta_{i j}^m=\left\{\begin{array}{l}1 \text { si } m=k \\ 0 \text { si } m \neq k\end{array}\right. $
Les matrices $\left(\Delta_i\right)_j^k=\Delta_{i j}^k$, $i=1, \cdots, n_G$, forment une représentation du groupe $G$ appelée représentation régulière.
pour alléger l’écriture, on se permettra de confondre nom de l’élément et indice (par exemple $a=g_a$, tel que $a g_k=g_m \Delta_{a k}^m$).
Si $a b=c$, alors $a b g_j=a g_m \Delta_{b j}^m=g_k \Delta_{a m}^k \Delta_{b j}^m$, or $c g_j=g_k \Delta_{c j}^k$ et comme $a b g_j=c g_j$ alors $\Delta_{a m}^k \Delta_{b j}^m=\Delta_{c j}^k$.
Par conséquent $\left(\Delta_a\right)\left(\Delta_b\right)=\left(\Delta_c\right)$.
La représentation régulière est une illustration du théorème de Cayley stipulant que tout groupe est isomorphe à un sous-groupe du groupe des permutations. En effet, la représentation régulière n’est rien d’autre que la représentation des permutations du groupe : elle dit à la place de qui chaque élément permute sous l’action d’un élément donné. Dans les deux cas, on représente bien l’action de $G$ sur lui-même par translation à gauche.
le théorème de Cayley dit qu’à tout $a\in G$ on peut faire correspondre un $p_a \in S_n$ défini par $p_a(g)=a g$, pour tout $g\in G$.
Or, sur le modèle de la preuve qui précède, on peut faire correspondre à tout $a$ une matrice $\Delta_a$ définie par :
$\displaystyle a g_m=g_k\left(\Delta_a\right)_m^k\quad $ avec $\displaystyle \quad \Delta_{a m}^k=\left\{\begin{array}{l}1 \text { si } k=a m \\ 0 \text { si } k \neq a m\end{array}\right. $
en écrivant $am$ tel que $a g_m \equiv g_{a m}$.
Or par définition $p_a\left(g_m\right)=a g_m \equiv g_{a m}=g_k \delta_{a m}^k$ avec $\delta_{a m}^k=\left\{\begin{array}{l}1 \text { si } k=a m \\ 0 \text { si } k \neq a m\end{array}\right.$
C’est bien la même chose, et la forme en $\delta_{a m}^k$ permet d’ailleurs de prouver à nouveau que la représentation régulière est bien une représentation :
$\left(\Delta_a\right)_m^k\left(\Delta_b\right)_j^m=\delta_{a m}^k \delta_{b j}^m=\delta_{a b j}^k=\delta_{c j}^k=\left(\Delta_c\right)_j^k$
où la troisième égalité découle de $g_{a b i}=a g_{b i}=a\left(b g_i\right)=(a b) g_i=c g_i=g_{c i}$.
Remarque :
la matrice d’une représentation régulière contient un $1$ par ligne et un $1$ par colonne, tous les autres éléments étant nuls. C’est une sorte de Sudoku ultra simple. On peut aussi la voir comme une table de multiplication éclatée, où on regarde l’action de chaque élément séparément sur le groupe.
La représentation régulière contient chacune des représentations irréductibles inéquivalentes $\mu$ un nombre $n_\mu$ de fois ($n_\mu$ est la dimension de la représentation $\mu$).
Calculons les caractères de la représentation régulière.
Pour $b=e$ (élément neutre), $\chi_e=\Delta_{e k}^k=n_G$ (puisque $\Delta_{e j}^k=\delta_j^k$).
Pour $b \neq e$, $b g_k \neq g_k$ et donc tous les éléments diagonaux de la matrice $\Delta_b$ sont nuls. Donc $\chi_b=\Delta_{b k}^k=0$ pour tous les $k$ (de 1 à $n_G$) et $b \in G \neq e$.
On peut alors trouver le nombre de fois que chaque représentation irréductible intervient dans la décomposition :
$a_\mu=\sum_i\left(n_i / n_G\right) \chi_\mu^{\dagger i} \chi_i=\left(n_e / n_G\right) \chi_\mu^{\dagger e} \chi_e=\left(1 / n_G\right) n_\mu n_G=n_\mu$
On en déduit la relation si longuement promise :
$\displaystyle \displaystyle \sum_\mu n_\mu^2=n_G $
D’après ce qui précède, $\Delta_e=\sum_\mu n_\mu U^\mu(e)$ et en récupérant la trace, $\chi_e=n_G=\sum_\mu n_\mu^2$.
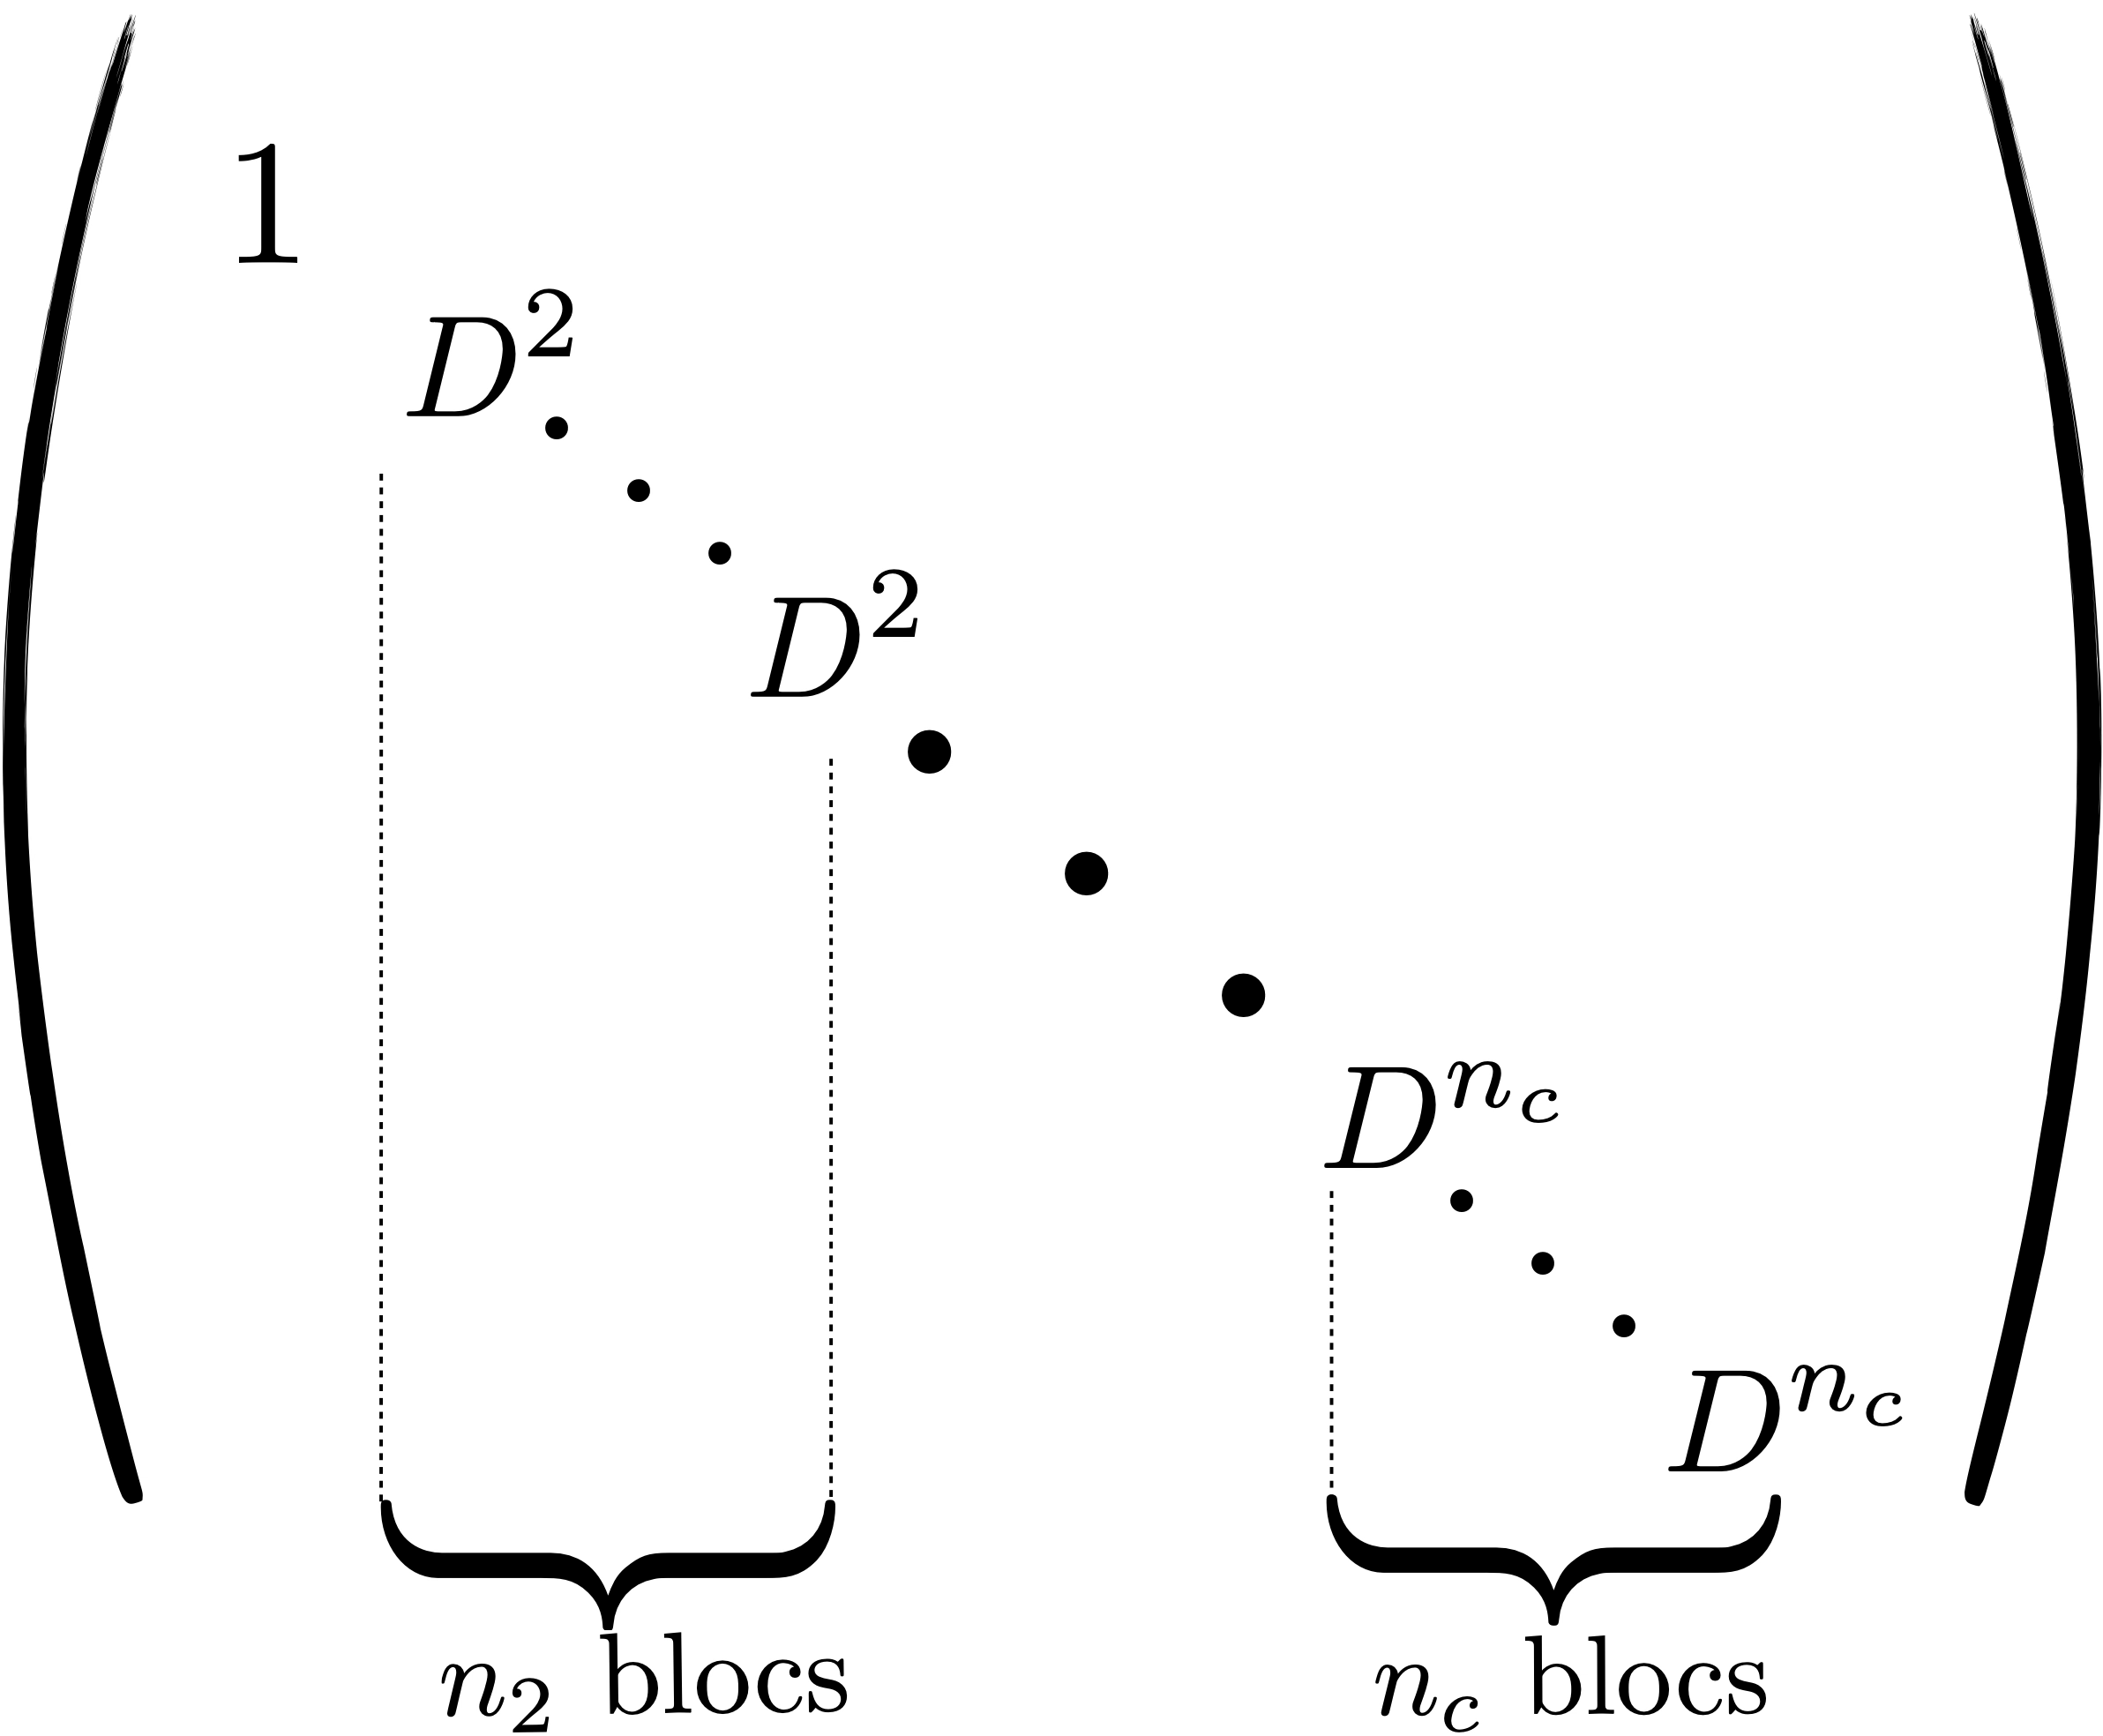
En réduisant systématiquement la représentation régulière de n’importe quel groupe $G$ en ses composantes irréductibles, on obtient toutes les représentations irréductibles inéquivalentes du groupe. Et avec le bon choix de base, on peut se retrouver avec toutes les matrices de la représentation régulière diagonalisées par bloc :
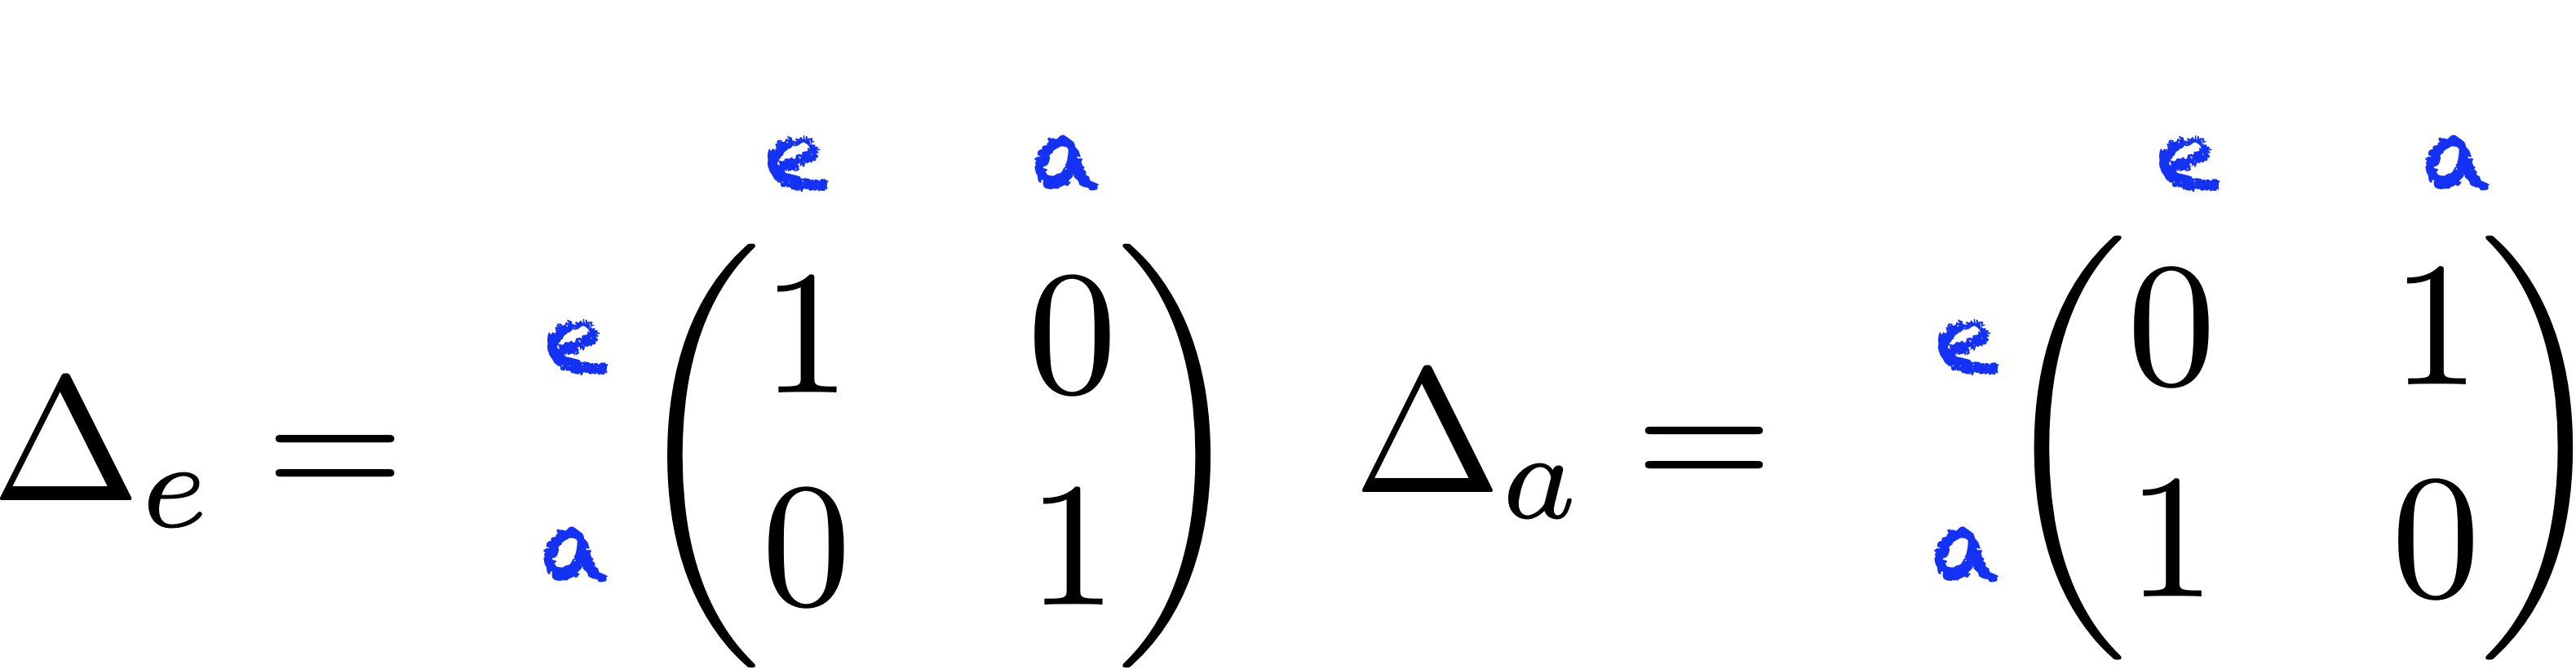
La représentation de $\mathrm{C_2}=\{e,a\}$ présentée plus haut était déjà une représentation régulière puisqu’on a bien, dans une base formée par les éléments du groupe :
On passe alors à une forme diagonale pour les deux matrices par un changement de base $\Delta_i^{\prime}=S \Delta_i S^{-1}$ avec comme matrice de changement de base $S=\left(\begin{array}{cc} 1 & 1 \\ -1 & 1 \end{array}\right)$ :
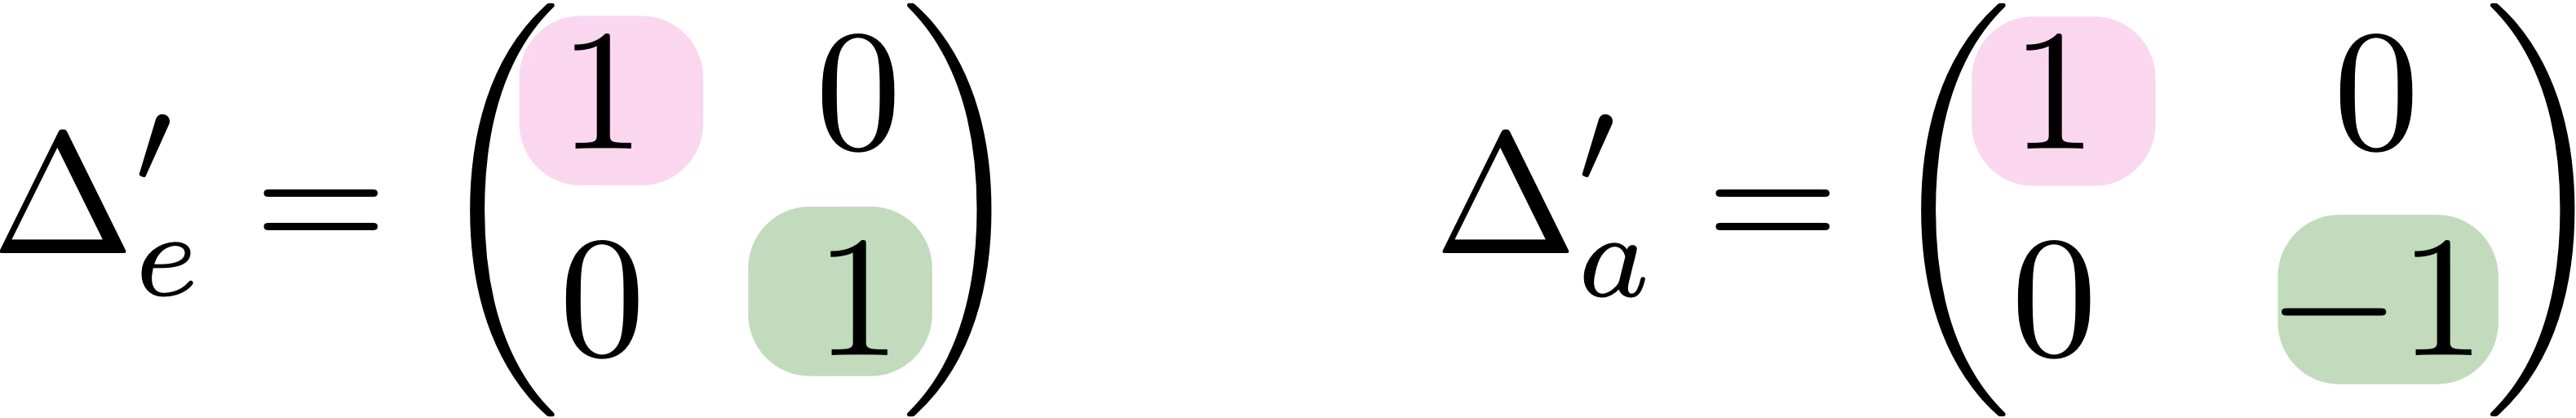
rendant explicite la décomposition où chacune des représentations irréductibles unidimensionnelles apparaît bien une fois.
Un premier aperçu physique
Tout cela est bien merveilleux mais on parle encore assez peu de physique. Cela va venir…
Contentons-nous dans un premier temps d’évoquer à nouveau les représentations du groupe $\mathrm{D_3}$ des symétries du triangle équilatéral laissant invariante la molécule de $\ce{NH3}$. L’analyse du spectre et des orbitales possibles de la molécule tire grandement parti de l’étude des représentations du groupe, mais revenons plus fondamentalement sur les trois types de représentations irréductibles.
Comme on le verra plus loin, la description mathématique d’un système physique est façonnée par les représentations émergeant des groupes de symétrie le laissant invariant. Entre autres, la théorie des représentations dicte le type même de grandeurs physiques pouvant décrire le système.
Sur l’exemple de $\mathrm{D_3}$, aux trois représentations irréductibles non équivalentes du groupe correspondent trois sortes de quantités se transformant linéairement dans une transformation du triangle :
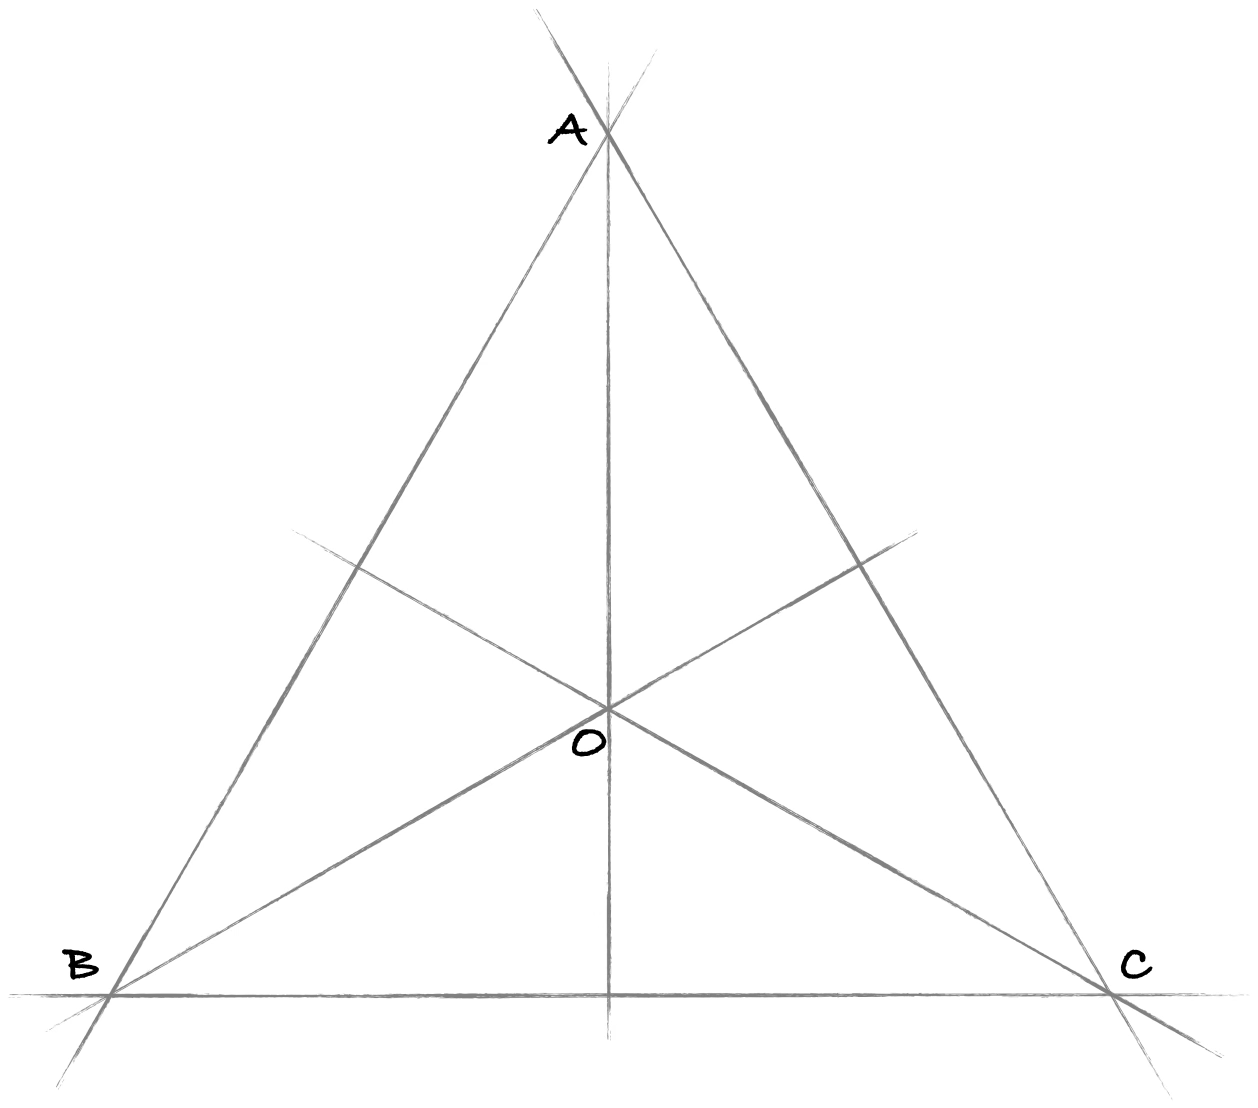
- les grandeurs se transformant suivant la 3ème représentation sont les vecteurs, définis par l’action qu’ont sur eux les rotations (elles les font tourner) et les réflexions (elles les inversent).
ex : $\overrightarrow{OA}$, $\overrightarrow{OB}$, $\overrightarrow{AB}$ sont des vecteurs (on peut le vérifier...) - les grandeurs se transformant suivant la 1ère représentation (les $1$) sont les scalaires, invariants par rotation ou réflexion.
ex : $OA^2$ - les grandeurs se transformant suivant la 2ème représentation (les $1$ et $-1$) sont les pseudo-scalaires. Ils sont laissés invariants par les rotations mais pas par la parité (réflexion).
ex : le produit vectoriel entre deux vecteurs, défini comme $\overrightarrow{OA} \wedge \overrightarrow{OB}=(OA)_x(OB)_y-(OA)_y(OB)_x$
La description d’un système physique invariant par l’action du groupe $\mathrm{D_3}$ se fera nécessairement par l’intermédiaire de ces grandeurs…
Produit tensoriel de représentations
En physique, on a plus souvent affaire à des produits directs d’espaces vectoriels qu’à des espaces simples. La raison ? Dès qu’un système contient plusieurs degrés de liberté, chacun va s’ébattre dans un espace qui lui est propre et le système entier sera alors décrit dans un grand espace, produit des petits espaces correspondant à chacun des degrés.
On va donc s’attarder un peu sur les produits directs de représentations.
Soient $U$ et $V$ deux espaces préhilbertiens (espaces vectoriels réels ou complexes munis d’un produit scalaire) munis chacun d’une base orthonormale $\{\left|u_i\right\rangle ; i=1, \cdots, n_U\}$ et $\{\left|v_j\right\rangle ; j=1, \cdots, n_V\}$.
L’espace vectoriel produit $W=U \otimes V$ est alors formé de toutes les combinaisons linéaires des vecteurs de base orthonormés $\{\left|w_k\right\rangle ; k=(i, j) ; i=1, \cdots, n_U ; j=1, \cdots, n_V\}$ où les $\left|w_k\right\rangle$ sont définis comme le produit $\left|w_k\right\rangle=\left|u_i\right\rangle \otimes\left|v_j\right\rangle$ (qu’on peut aussi écrire $\left|w_k\right\rangle=\left|u_i\right\rangle\left|v_j\right\rangle$ ou $\left|w_k\right\rangle=\left|u_i, v_j\right\rangle$).
Par définition :
- $\left\langle w_{k^{\prime}} \mid w_k\right\rangle=\delta_k^{k^{\prime}}=\delta_i^{i^{\prime}} \delta_j^{j^{\prime}}$ avec $k^{\prime}=\left(i^{\prime}, j^{\prime}\right)$ et $k=(i, j)$,
- $W=\{|x\rangle=\left|w_k\right\rangle x^k\}$ où les $x^k$ sont les composantes de $x$,
- $\langle x \mid y\rangle \equiv x_k^{\dagger} y^k$ où $x_k^{\dagger}=\left(x^k\right)^*$.
Pour des opérateurs $A$ et $B$ définis respectivement sur $U$ et $V$, on associe sur le produit tensoriel $W=U \otimes V$ l’opérateur $D \equiv A \otimes B$ tel que $D\left|w_k\right\rangle=\left|w_{k^{\prime}}\right\rangle D_k^{k^{\prime}}$ avec $D_k^{k^{\prime}} \equiv A_i^{i^{\prime}} B_j^{j^{\prime}}$.
Dans la plupart des applications, les opérateurs $A$ et $B$ correspondent au même opérateur physique opérant sur deux espaces vectoriels $U$ et $V$ (il pourrait par exemple s’agir de l’hamiltonien de chacune des particules dans un système quantique à deux particules). $D$ correspond alors encore au même opérateur, mais sur l’espace vectoriel produit (l’hamiltonien du système à deux particules, en suivant l’exemple).
Adaptons aux représentations :
Soit $G$ un groupe de symétrie, $D^\mu(G)$ et $D^\nu(G)$ des représentations de $G$ sur les espaces vectoriels $U$ et $V$.
Alors les opérateurs $D^{\mu \times \nu}(g)=D^\mu(g) \otimes D^\nu(g)$ sur $W=U \otimes V$, pour tout $g\in G$, forment aussi une représentation de $G$.
$D^{\mu \times \nu}(G)$ est le produit tensoriel (ou produit direct) des représentations $D^\mu(G)$ et $D^\nu(G)$.
le produit direct conserve l’homomorphisme des représentations :
$$ \begin{aligned} D^{\mu \times \nu}\left(g_1\right) D^{\mu \times \nu}\left(g_2\right) & =D^\mu\left(g_1\right) D^\mu\left(g_2\right) \otimes D^\nu\left(g_1\right) D^\nu\left(g_2\right) \\ & =D^\mu\left(g_1 \cdot g_2\right) \otimes D^\nu\left(g_1 \cdot g_2\right) \\ & =D^{\mu \times \nu}\left(g_1 \cdot g_2\right) \end{aligned} $$
Les caractères du produit tensoriel des représentations sont égaux au produit des caractères de chacune des représentations : $\chi^{\mu \times \nu}=\chi^\mu \chi^\nu$
$\chi^{\mu \times \nu}=\operatorname{Tr} D^{\mu \times \nu}(g)=D^\mu(g)_i^i D^\nu(g)_j^j=\chi^\mu \chi^\nu$ où $g$ est un élément quelconque du groupe appartenant à la classe considérée.
Si $D^\mu(G)$ et $D^\nu(G)$ sont des représentations irréductibles de $G$ de dimensions respectives $n_\mu$ et $n_\nu$, alors $D^{\mu \times \nu}(G)$ est une représentation de dimension $n_\mu \times n_\nu$ habituellement réductible.
Le nombre de fois $a_\lambda$ qu’une représentation $D^\lambda(G)$ apparaît dans la décomposition de $D^{\mu \times \nu}(G)$ est donné par la relation vue plus haut :
$$ a_\lambda^{\mu \times \nu}=\tilde{\chi}_\lambda^{\dagger} \cdot \tilde{\chi}^{\mu \times \nu}=\sum_i\left(n_i / n_G\right)\left(\chi_i^\lambda\right)^* \chi_i^\mu \chi_i^\nu $$
Étudions le produit des représentations irréductibles de $\mathrm{S_3}$. D’après la table de caractères vue plus haut, on déduit :
$D^{1 \times 1} \sim D^1$, $D^{1 \times 2} \sim D^2$, $D^{2 \times 2} \sim D^1$, $D^{1 \times 3} \sim D^3$ et $D^{2 \times 3} \sim D^3$.
Pour $D^{3 \times 3}$, c’est moins immédiat : la représentation est à 4 dimensions et peut donc être réduite. Appliquons la formule détaillant la décomposition :
$$ \begin{aligned} a_1 & =\sum_i n_i / n_G\left(\chi_i^1\right)^* \chi_i^3 \chi_i^3=\frac{1}{6} \times 1 \times 2^2+\frac{3}{6} \times 1 \times 0^2+\frac{2}{6} \times 1 \times(-1)^2=1 \\ a_2 & =\sum_i n_i / n_G\left(\chi_i^2\right)^* \chi_i^3 \chi_i^3=\frac{1}{6} \times 1 \times 2^2+\frac{3}{6} \times(-1) \times 0^2+\frac{2}{6} \times 1 \times(-1)^2=1 \\ a_3 & =\sum_i n_i / n_G\left(\chi_i^3\right)^* \chi_i^3 \chi_i^3=\frac{1}{6} \times 2 \times 2^2+\frac{3}{6} \times 0 \times 0^2+\frac{2}{6} \times(-1) \times(-1)^2=1 \end{aligned} $$
Les représentations $D^1$, $D^2$ et $D^3$ apparaissent donc chacune une fois dans la décomposition de $D^{3 \times 3}$.
Coefficients de Clebsch-Gordan
On peut écrire en général $D^{\mu \times \nu}=\sum_{\lambda \oplus} a_\lambda D^\lambda$.
L’espace vectoriel $W$ est alors décomposé en une somme directe de sous-espaces stables $W_\alpha^\lambda$, où $\lambda$ désigne la représentation irréductible et $\alpha$ ($=1, \cdots, a_\lambda$) distingue les espaces correspondant à un même $\lambda$.
On peut alors choisir une base de $W$ telle que les $n_1$ premiers vecteurs appartiennent à $W_1^1$, les $n_2$ suivants à $W_1^2$, etc. Dans cette nouvelle base, toutes les représentations matricielles seront diagonales par bloc.
En notant $\{\left|w_{\alpha l}^\lambda\right\rangle ; l=1, \cdots, n_\lambda ; \alpha=1, \cdots, a_\lambda\}$ (avec $\lambda$ parcourant les représentations irréductibles) les vecteurs orthonormaux de cette nouvelle base, on peut écrire la transformation unitaire les liant à l’ancienne base $\{\left|w_k\right\rangle ; k=(i, j) ; i=1, \cdots, n_U ; j=1, \cdots, n_V\}$ :
$\left|w_{\alpha l}^\lambda\right\rangle=\sum_{i, j}\left|w_{i, j}\right\rangle\left\langle i, j\right.$ $(\mu, \nu)\left|\alpha, \lambda, l\right\rangle$
ou plus simplement $|\alpha, \lambda, l\rangle=\sum_{i, j}|i, j\rangle\langle i, j \mid \alpha, \lambda, l\rangle$, ou encore plus simple (sommation implicite sur les indices répétés) :
$\displaystyle |\alpha, \lambda, l\rangle=|i, j\rangle\langle i, j \mid \alpha, \lambda, l\rangle $
Les $\langle i, j \mid \alpha, \lambda, l\rangle$ sont les éléments de la matrice semblable de changement de base, dont les lignes sont indexées par les $(i, j)$ et les colonnes par $(\alpha, \lambda, l)$. Ce sont des nombres complexes appelés coefficients de Clebsch-Gordan.
Remarque :
attention, avec cette dernière notation on perd de vue que la transformation s’occupe du passage de $D^{\mu \times \nu}$ à $D^\lambda$. Il faut donc se rappeler que les $|i\rangle$ pavent l’espace $U$ où joue $D^\mu$ et les $|j\rangle$ l’espace $V$ où joue $D^\nu$.
Les coefficients de Clebsch-Gordan sont eux-mêmes orthonormaux et complets :
$$ \begin{aligned} &\sum_{\alpha, \lambda, l}\left\langle i^{\prime}, j^{\prime} \mid \alpha, \lambda, l\right\rangle\langle\alpha, \lambda, l \mid i, j\rangle=\delta_i^{i^{\prime}} \delta_j^{j^{\prime}} \\ &\sum_{i, j}\left\langle\alpha^{\prime}, \lambda^{\prime}, l^{\prime} \mid i, j\right\rangle\langle i, j \mid \alpha, \lambda, l\rangle=\delta_\alpha^{\alpha^{\prime}} \delta_\lambda^{\lambda^{\prime}} \delta_l^{l^{\prime}} \end{aligned} $$
avec $\langle\alpha, \lambda, l \mid i, j\rangle \equiv\langle i, j \mid \alpha, \lambda, l\rangle^*$
Ces relations sont la conséquence directe de l’orthonormalité et de la complétude des bases $\{\left|w_{i, j}\right\rangle\}$ et $\{\left|w_{\alpha l}^\lambda\right\rangle\}$.
On peut rendre plus explicite la forme diagonale par bloc de la représentation produit tensoriel dans la nouvelle base grâce au théorème suivant (les sommes sur indices répétés sont implicites) :
Réduction de la représentation produit tensoriel :
la matrice semblable composée des coefficients de Clebsch-Gordan décompose la représentation produit tensoriel $D^{\mu \times \nu}$ en ses composantes irréductibles. On a alors les relations réciproques suivantes :
$$ \begin{aligned} &D^\mu(g)_i^{i^{\prime}} D^\nu(g)_j^{j^{\prime}}=\left\langle i^{\prime}, j^{\prime} \mid \alpha, \lambda, l^{\prime}\right\rangle D^\lambda(g)_l^{l^{\prime}}\langle\alpha, \lambda, l \mid i, j\rangle \qquad\text{(a)}\\ &\delta_\alpha^{\alpha^{\prime}} \delta_{\lambda^{\prime}}^\lambda D^\lambda(g)_l^{l^{\prime}}=\left\langle\alpha^{\prime}, \lambda^{\prime}, l^{\prime} \mid i^{\prime}, j^{\prime}\right\rangle D^\mu(g)_i^{i^{\prime}} D^\nu(g)_j^{j^{\prime}}\langle i, j \mid \alpha, \lambda, l\rangle \end{aligned} $$
L’inverse de (a) est bien sûr $|i, j\rangle=|\alpha, \lambda, l\rangle\langle\alpha, \lambda, l \mid i, j\rangle$ (b).
Et on sait que les deux bases sont définies par :
$U(g)|i, j\rangle=\left|i^{\prime}, j^{\prime}\right\rangle D^\mu(g)_i^{i^{\prime}} D^\nu(g)_j^{j^{\prime}}$ (c)
$U(g)|\alpha, \lambda, l\rangle=\left|\alpha, \lambda, l^{\prime}\right\rangle D^\lambda(g)_l^{l^{\prime}}$ (d)
Utilisons (b) sur le membre de gauche de (c), cela donne :
$$ \begin{aligned} U(g)|i, j\rangle & =U(g)|\alpha, \lambda, l\rangle\langle\alpha, \lambda, l \mid i, j\rangle \\ & =\left|\alpha, \lambda, l^{\prime}\right\rangle D^\lambda(g)_l^{l^{\prime}}\langle\alpha, \lambda, l \mid i, j\rangle \\ & =\left|i^{\prime}, j^{\prime}\right\rangle\left\langle i^{\prime}, j^{\prime} \mid \alpha, \lambda, l^{\prime}\right\rangle D^\lambda(g)_l^{l^{\prime}}\langle\alpha, \lambda, l \mid i, j\rangle \end{aligned} $$
où on a utilisé (d) à la deuxième ligne et (a) à la troisième.
En comparant au membre de droite de (c), on obtient la première relation du théorème (les vecteurs de base sont linéairement indépendants).
Pour obtenir la relation réciproque, on peut utiliser la même méthode en substituant (a) dans (d), ou partir de la première relation et utiliser la complétude des coefficients de Clebsch-Gordan :
$$ \begin{aligned} &\left\langle\alpha^{\prime}, \lambda^{\prime}, l^{\prime} \mid i^{\prime}, j^{\prime}\right\rangle D^\mu(g)_i^{i^{\prime}} D^\nu(g)_j^{j^{\prime}}\langle i, j \mid \alpha, \lambda, l\rangle \\ &\qquad =\left\langle\alpha^{\prime}, \lambda^{\prime}, l^{\prime} \mid i^{\prime}, j^{\prime}\right\rangle\left\langle i^{\prime}, j^{\prime} \mid \alpha, \lambda, l^{\prime}\right\rangle D^\lambda(g)_l^{l^{\prime}}\langle\alpha, \lambda, l \mid i, j\rangle\langle i, j \mid \alpha, \lambda, l\rangle \end{aligned} $$
Or $\left\langle\alpha^{\prime}, \lambda^{\prime}, l^{\prime} \mid i^{\prime}, j^{\prime}\right\rangle\left\langle i^{\prime}, j^{\prime} \mid \alpha, \lambda, l^{\prime}\right\rangle=\delta_\alpha^{\alpha^{\prime}} \delta_\lambda^{\lambda^{\prime}}$ et $\langle\alpha, \lambda, l \mid i, j\rangle\langle i, j \mid \alpha, \lambda, l\rangle=1$.
C’est $\delta_\alpha^{\alpha^{\prime}} \delta_{\lambda^{\prime}}^\lambda D^\lambda(g)_l^{l^{\prime}}=\left\langle\alpha^{\prime}, \lambda^{\prime}, l^{\prime} \mid i^{\prime}, j^{\prime}\right\rangle D^\mu(g)_i^{i^{\prime}} D^\nu(g)_j^{j^{\prime}}\langle i, j \mid \alpha, \lambda, l\rangle$, qui montre clairement la forme diagonale par bloc de la représentation produit dans la nouvelle base puisque cette relation implique que la matrice semblable soit diagonale pour deux des trois indices ($\lambda$ et $\alpha$).
En physique, les coefficients de Clebsch-Gordan apparaissent principalement lors de l’étude du couplage de moments angulaires en mécanique quantique.
L’interaction électromagnétique étant invariante par rotation 3D, l’étude de ses représentations (qui sera menée plus loin) montre qu’un état peut être décrit par un vecteur $|j, m\rangle$ où le «nombre quantique» $j$ désigne la magnitude du moment angulaire et $m$ sa composante sur un «axe de quantification» donné.
Il est fréquent de devoir étudier le couplage entre deux états $\left|j_1, m_1\right\rangle$ et $\left|j_2, m_2\right\rangle$ (c’est le domaine de la spectroscopie) et le passage à une base commune correspond à décomposer irréductiblement la transition elle-même (ce qui donne les photons). Les coefficients de Clebsch-Gordan correspondants $\left\langle j_1 m_1 j_2 m_2 \mid J M\right\rangle$ sont donnés dans des tables et dans ce cas particulier $\alpha=1$, car chaque représentation irréductible n’apparaît qu’une fois dans la décomposition du produit direct $\left|j_1, m_1\right\rangle \otimes\left|j_2, m_2\right\rangle$.
Vecteurs et opérateurs irréductibles, opérateurs de projection
À partir du moment où un système physique possède une symétrie, les solutions des équations d’évolution (ou les vecteurs d’états, dans un langage plus quantique) se structurent autour des représentations irréductibles de la symétrie.
Il en est de même des observables physiques telles que la position, l’impulsion, ou encore le champ électromagnétique. Tout comme les vecteurs d’état, une symétrie donnée les transforme de manière spécifique. Ces observables se comportent ainsi comme le type de grandeurs avec lesquelles jouent les représentations irréductibles de la symétrie (des vecteurs si la symétrie aime jouer avec des vecteurs, des tenseurs de rang 2 si ça lui sied plus, etc.).
Savoir décomposer un jeu arbitraire de vecteurs d’état et d’opérateurs censés rester invariants sous l’effet d’une certaine symétrie en leurs composantes irréductibles permettrait donc d’obtenir la description la plus adaptée du système physique au problème donné.
Soit $U(G)$ une représentation unitaire définie sur un espace vectoriel préhilbertien $V$, et soit $V_\mu$ un sous-espace invariant sous l’action de $U(G)$ avec $\{\hat{e}_i^\mu ; i=1, \ldots, n_\mu\}$ une base orthonormée de $V_\mu$. Par définition :
$\displaystyle U(g)\left|e_i^\mu\right\rangle=\left|e_j^\mu\right\rangle D^\mu(g)_i^j \qquad \forall g \in G $
Ces vecteurs $\hat{e}_i^\mu$, engendrant l’espace sur lequel joue la représentation irréductible $\mu$, sont appelés vecteurs (de base) irréductibles.
Soit $\{\hat{u}_i^\mu ; i=1, \ldots, n_\mu\}$ et $\{\hat{v}_i^\nu ; i=1, \ldots, n_\nu\}$ deux bases de vecteurs irréductibles selon deux représentations $\mu$ et $\nu$. Si les deux représentations irréductibles $\mu$ et $\nu$ ne sont pas équivalentes, alors les deux sous-espaces invariants qu’engendrent les deux bases sont orthogonaux entre eux.
$$ \begin{aligned} \left\langle v_\nu^j \mid u_i^\mu\right\rangle & =\left\langle v_\nu^j\right| U^{\dagger}(g) U(g)\left|u_i^\mu\right\rangle \\ & =D_\nu^{\dagger}(g)_k^j\left\langle v_\nu^k \mid u_l^\mu\right\rangle D^\mu(g)_i^l \\ & =n_G^{-1} \sum_g D_\nu^{\dagger}(g)_k^j D^\mu(g)_i^l\left\langle v_\nu^k \mid u_l^\mu\right\rangle \\ & =n_\mu^{-1} \delta_\nu^\mu \delta_i^j \delta_l^k\left\langle v_\nu^k \mid u_l^\mu\right\rangle \\ & =n_\mu^{-1} \delta_\nu^\mu \delta_i^j\left\langle v_\nu^k \mid u_k^\mu\right\rangle \end{aligned} $$
Dans la première égalité, on a utilisé l’unitarité de $U$ ; la seconde vient de la définition qui précède ; la troisième est notre désormais courante astuce de moyennage (on peut introduire la somme dès la première ligne pour mieux voir qu’elle ne change rien) ; et dans la quatrième, on applique les conditions d’orthonormalité.
En conclusion, on voit que si $\mu \neq \nu$, chaque vecteur de la première base est orthogonal à tous les vecteurs de l’autre base.
On généralise ainsi le fait que des vecteurs propres d’un opérateur hermitien correspondant à des valeurs propres différentes sont orthogonaux. Là, le vecteur propre devient l’espace propre sur lequel agit la représentation irréductible et la valeur propre correspond au $\mu$ qui distingue les représentations.
Que dire si $\mu=\nu$ ? Deux possibilités : soit les deux sous-espaces ne coïncident aucunement (les deux espaces se distinguent alors par la valeur propre d’un autre opérateur, non lié au groupe de symétrie considéré), soit ils coïncident complètement (les deux bases sont alors liées par une matrice semblable).
Cela éclaire certains résultats plus familiers comme, par exemple, la fonction d’onde de l’électron d’un atome d’hydrogène (l’espace est alors l’espace de Hilbert). Le groupe de symétrie est $\mathrm{R_3}$ (rotations à 3D) et les représentations irréductibles de $\mathrm{R_3}$, comme on le verra plus loin, sont les différents moments angulaires. Or on sait que des états de moments angulaires différents (cas $\mu \neq \nu$), quel que soit le nombre quantique principal (correspondant à l’éloignement radial), sont orthogonaux. Et c’est aussi le cas d’états de même moment angulaire mais de nombre quantique principal différent (cas $\mu=\nu$ mais non coïncident).
Les opérateurs de projection
Reste à savoir comment construire une base de vecteurs irréductibles à partir d’un ensemble quelconque de vecteurs.
À l’image de l’opérateur de projection $E_i=\left|e_i\right\rangle\left\langle e_i\right|$ qui décompose un vecteur quelconque $|x\rangle$ sur la base $\left|e_i\right\rangle$, on va construire un opérateur de projection qui transforme un vecteur quelconque $|x\rangle$ en un vecteur de base irréductible selon une représentation irréductible donnée.
Soit $U(G)$ une représentation du groupe $G$ sur un espace vectoriel $V$, et $D^\mu(G)$ la matrice d’une représentation irréductible de $G$. On construit un opérateur de projection généralisé de la manière suivante :
$\displaystyle P_{\mu i}^j=\frac{n_\mu}{n_G} \sum_g D_\mu^{-1}(g)_i^j\, U(g) $
Et avec des représentations unitaires ($D^{-1}(g)=D^{\dagger}(g)$) :
$\displaystyle P_{\mu i}^j=\frac{n_\mu}{n_G} \sum_g D_\mu^{\dagger}(g)_i^j\, U(g) $
Alors pour tout vecteur $|x\rangle$ de $V$, l’ensemble des vecteurs $\{P_{\mu i}^j|x\rangle ; i=1, \ldots, n_\mu\}$, avec un $j$ fixé, forment une base de vecteurs irréductibles selon la représentation $\mu$.
En oubliant le facteur de normalisation $\left(n_\mu / n_G\right)$, on a :
$$ \begin{aligned} U(g) P_{\mu i}^j|x\rangle & =\sum_{g^{\prime}} U(g) U\left(g^{\prime}\right)|x\rangle D_\mu^{-1}\left(g^{\prime}\right)_i^j \\ & =\sum_{g^{\prime}} U\left(g g^{\prime}\right)|x\rangle D_\mu^{-1}\left(g^{\prime}\right)_i^j \\ & =\sum_{g^{\prime \prime}} U\left(g^{\prime \prime}\right)|x\rangle D_\mu^{-1}\left(g^{-1} g^{\prime \prime}\right)_i^j \\ & =\sum_{g^{\prime \prime}} U\left(g^{\prime \prime}\right)|x\rangle D_\mu^{-1}\left(g^{\prime \prime}\right)_k^j D_\mu^{-1}\left(g^{-1}\right)_i^k \\ & =P_{\mu k}^j|x\rangle D^\mu(g)_i^k \end{aligned} $$
Soit $\{\hat{e}_k^\nu ; k=1, \ldots, n_\nu\}$ une base de vecteurs irréductibles, alors :
$\displaystyle P_{\mu i}^j\left|e_k^\nu\right\rangle=\left|e_i^\nu\right\rangle \delta_\nu^\mu \delta_k^j $
$$ \begin{aligned} P_{\mu i}^j\left|e_k^\nu\right\rangle & =\left(n_\mu / n_G\right) \sum_g U(g)\left|e_k^\nu\right\rangle D_\mu^{\dagger}(g)_i^j \\ & =\left|e_l^\nu\right\rangle\left(n_\mu / n_G\right) \sum_g D^\nu(g)_k^l D_\mu^{\dagger}(g)_i^j \\ & =\left|e_l^\nu\right\rangle \delta_\nu^\mu \delta_i^l \delta_k^j \\ & =\left|e_i^\nu\right\rangle \delta_\nu^\mu \delta_k^j \end{aligned} $$
Donc $P_{\mu i}^j\left|e_k^\nu\right\rangle=0$ si $\mu \neq \nu$, et $P_{\mu i}^j\left|e_k^\nu\right\rangle=\left|e_i^\mu\right\rangle \delta_k^j$ si $\mu=\nu$.
Cela montre que $P_{\mu i}^j$ n’est pas tout à fait un opérateur de projection car il faudrait pour cela plutôt un $\delta_k^i$. On va construire un peu plus loin de vrais opérateurs de projection à partir de cet opérateur plus général, mais seul celui-ci permet, et c’est ce qui le rend si utile, de construire une base de vecteurs irréductibles à partir d’un vecteur quelconque.
Précisons d’abord quelques propriétés de ce premier opérateur.
$\displaystyle P_{\mu i}^j P_{\nu k}^l=\delta_\nu^\mu \delta_k^j P_{\mu i}^l $
$\{P_{\nu k}^l|x\rangle ; k=1, \ldots, n_\nu\}$ étant une base de vecteurs irréductibles, $P_{\mu i}^j P_{\nu k}^l|x\rangle=P_{\nu i}^l|x\rangle \delta_\nu^\mu \delta_k^j$ pour tout $|x\rangle \in V$.
Les $n_G$ opérateurs $U(g)$ peuvent s’écrire comme des combinaisons linéaires des $P_{\mu i}^j$ ($\mu=1, \ldots, n_c ; i, j=1, \ldots, n_\mu$) :
$\displaystyle U(g)=\sum_{\mu, i, j} P_{\mu i}^j D^\mu(g)_j^i $
Ce n’est que l’inverse de la définition de $P_{\mu i}^j$. On en déduit :
$\displaystyle U(g) P_{\nu k}^l=\sum_i P_{\nu i}^l D^\nu(g)_k^i $
Qu’on démontre avec $P_{\mu i}^j P_{\nu k}^l=\delta_\nu^\mu \delta_k^j P_{\mu i}^l$ et qui ne fait que réexprimer sous forme «opérateurs» le fait que $P_{\nu k}^l$ permette de former une base irréductible selon la représentation $\nu$. Il suffit de se rappeler la définition du vecteur de base irréductible, $U(g)\left|e_i^\nu\right\rangle=\left|e_j^\nu\right\rangle D^\nu(g)_i^j$, pour s’en assurer.
Construisons maintenant de vrais opérateurs de projection :
- $P_{\mu i} \equiv P_{\mu i}^{j=i}$ est l’opérateur de projection sur le vecteur de base $\hat{e}_i^\mu$.
- $P_\mu \equiv \sum_i P_{\mu i}$ est l’opérateur de projection sur le sous-espace invariant irréductible $V_\mu$ (de base $\{\hat{e}_i^\mu ; i=1, \ldots, n_\mu\}$).
Remarque :
$P_\mu$ s’écrit en fonction du caractère de la représentation $\mu$ : $\displaystyle P_\mu=\frac{n_\mu}{n_G} \sum_g \chi^{\dagger}(g), U(g)$
$P_{\mu i} P_{\nu k}=P_{\mu i}^i P_{\nu k}^k=P_{\mu i}^i \delta_\nu^\mu \delta_i^k=P_{\mu i} \delta_\nu^\mu \delta_i^k$ (exceptionnellement, on ne somme pas sur les indices répétés).
Et $\displaystyle P_\mu P_\nu=\sum_{i, k} P_{\mu i} P_{\nu k}=\sum_{i, k} P_{\mu i} \delta_\nu^\mu \delta_i^k=\delta_\nu^\mu \sum_i P_{\mu i}=\delta_\nu^\mu P_\mu$
Les opérateurs de projection $P_{\mu i}$ et $P_\mu$ sont complets : $\displaystyle \sum_\mu P_\mu=E$
Si $\{\hat{e}_k^\nu\}$ désignent la base de n’importe quel sous-espace invariant irréductible de $V$, on a $P_{\mu i}\left|e_k^\nu\right\rangle=P_{\mu i}^i\left|e_k^\nu\right\rangle=\left|e_i^\nu\right\rangle \delta_\nu^\mu \delta_k^i$ et $P_\mu\left|e_k^\nu\right\rangle=\left|e_k^\nu\right\rangle \delta_\nu^\mu$, d’où $\sum_\mu P_\mu\left|e_k^\nu\right\rangle=\left|e_k^\nu\right\rangle$.
Et comme cela vaut pour tout vecteur de base irréductible, $\sum_\mu P_\mu=E$, du moins si $V$ est complètement réductible (ce qu’on supposera toujours).
Qu’est-ce qui différencie le vrai projecteur, $P_{\mu i}$, et le projecteur «arrangé», $P_{\mu i}^j$ ?
Les deux projettent un vecteur quelconque de $V$ sur l’espace invariant irréductible $V_\mu$. Mais quand le premier, vrai projecteur, fournit un vecteur de base irréductible $\hat{e}_i^\mu$ précis à partir du vecteur d’entrée, le second projecteur sort quant à lui un vecteur de base irréductible orthogonal au vecteur projeté par le premier projecteur, un vecteur de base associé. Il a donc une double action : il projette sur un vecteur puis décale sur un vecteur orthogonal.
Le premier projecteur permet donc d’obtenir un vecteur irréductible donné de la base qui engendre $V_\mu$ et le second permet d’obtenir tous les autres.
$P_\mu$, lui, ne fait que projeter sur $V_\mu$ : il ne fournit pas de vecteurs de base irréductibles mais seulement un vecteur quelconque de $V_\mu$.
Clarifions un peu plus l’action de ces 3 projecteurs en prenant des vecteurs de base de l’espace $V$ tout entier.
Rappelons-nous tout d’abord que l’espace $V$ sur lequel agit la représentation $U(G)$ d’un groupe $G$ peut se décomposer complètement en une somme de sous-espaces invariants irréductibles $V_\alpha^\mu$, où $\mu$ désigne une représentation irréductible de dimension $n_\mu$ (il y a autant de représentations différentes que de classes distinctes $n_c$) et où, comme la même représentation irréductible peut apparaître plusieurs fois ($a_\mu$ fois) dans la décomposition, l’exposant $\alpha$ est là pour les distinguer.
Par conséquent, il faut 3 indices pour construire un ensemble complet de vecteurs de base engendrant l’espace $V$ et correspondant à cette réduction : $|\alpha, \mu, i\rangle$, $i=1, \ldots, n_\mu$, $\mu=1, \ldots, n_c$, $\alpha=1, \ldots, a_\mu$.
Et l’action des opérateurs de projection sur ces vecteurs s’écrit :
$$ \begin{aligned} &P_\mu|\alpha, \nu, k\rangle=|\alpha, \nu, k\rangle \delta_\nu^\mu \\ &P_{\mu i}|\alpha, \nu, k\rangle=|\alpha, \nu, k\rangle \delta_\nu^\mu \delta_k^i \\ &P_{\mu i}^j|\alpha, \nu, k\rangle=|\alpha, \nu, i\rangle \delta_\nu^\mu \delta_k^j \end{aligned} $$
On constate qu’aucun des projecteurs ne s’occupe de $\alpha$.
$P_\mu$ se contente de projeter sur $V_\mu$ sans s’occuper d’obtenir un vecteur irréductible donné (une combinaison linéaire est autorisée, $k$ n’étant pas fixé).
$P_{\mu i}$ choisit un seul vecteur irréductible, $|\alpha, \mu, i\rangle$, parmi tous ceux possibles.
$P_{\mu i}^j$ fournit lui aussi le vecteur irréductible $|\alpha, \mu, i\rangle$ mais seulement si on le fait agir sur $|\alpha, \mu, j\rangle$ !
Soit $V$ l’espace des fonctions de carré sommable $f(x)$, et $G$ le groupe $\{e, I_S\}$ où $I_S$ est l’opérateur de parité (inversion spatiale changeant $x$ en $-x$). Comme $G$ est isomorphe à $\mathrm{C_2}$, il contient deux représentations irréductibles unidimensionnelles.
Les deux opérateurs de projection sont alors $P_1=\frac{1}{2}\left[E+U\left(I_S\right)\right]$ et $P_2=\frac{1}{2}\left[E-U\left(I_S\right)\right]$ (puisque $U(e)=E$).
Donc pour toute fonction $f(x)$ : $P_1 f(x)=\frac{1}{2}[f(x)+f(-x)] \equiv f_{+}(x)$ et $P_2 f(x)=\frac{1}{2}[f(x)-f(-x)] \equiv f_{-}(x)$.
Il est clair que $f_{+}(x)$, fonction paire, et $f_{-}(x)$, fonction impaire, engendrent chacune un sous-espace invariant irréductible de $G$.
On aboutit donc à l’évidente conclusion que pour un système avec une symétrie de parité, l’utilisation de fonctions paires et impaires est avantageuse. L’utilisation de tout cet outillage de théorie des groupes n’était clairement pas nécessaire, mais on voit ainsi que ça marche…
Revenons à notre exemple fil rouge : la molécule de $\ce{NH3}$. Les projecteurs vont permettre de retrouver les vecteurs irréductibles de base de chacune des représentations.
On reprend la démarche entreprise plus haut consistant à partir d’une base constituée des 3 orbitales atomiques $(s_1, s_2, s_3)$ et à former, par combinaison linéaire de ces orbitales atomiques, des orbitales moléculaires se transformant selon chacune des représentations irréductibles du groupe. Les vecteurs irréductibles correspondront aux orbitales moléculaires recherchées.
Pour obtenir un vecteur irréductible d’une représentation donnée, il suffit d’appliquer $P_{\mu i}$ sur une des orbitales atomiques de départ. Dans le cas des représentations 1 et 2, unidimensionnelles, le vecteur obtenu sera logiquement unique. Les représentations unidimensionnelles permettent une autre simplification puisque $P_{\mu i}$ se confond alors avec $P_\mu$ :
$$ P_{\mu i}=P_{\mu i}^i=\frac{n_\mu}{n_G} \sum_g D_\mu^{\dagger}(g)_i^i, U(g)=\frac{n_\mu}{n_G} \sum_g \chi_\mu^{\dagger}(g), U(g)=P_\mu $$
Commençons par la première représentation. On obtient, en notant $e$, $a$, $b$, $c$, $d$, $f$ respectivement l’élément neutre, les réflexions (permutations deux à deux) $s_2 \leftrightarrow s_3$, $s_1 \leftrightarrow s_3$, $s_1 \leftrightarrow s_2$, et les rotations $s_1 \rightarrow s_2 \rightarrow s_3$ et $s_1 \rightarrow s_3 \rightarrow s_2$ :
$$ \begin{aligned} P_1 s_1 & =\frac{1}{6}\left[U(e) s_1+U(a) s_1+U(b) s_1+U(c) s_1+U(d) s_1+U(f) s_1\right] \\ & =\frac{1}{6}\left[s_1+s_1+s_3+s_2+s_2+s_3\right] \\ & =\frac{1}{3}\left[s_1+s_2+s_3\right] \end{aligned} $$
On obtient bien le vecteur irréductible de la représentation 1 que l’on avait présenté plus haut comme évident. En effet, la seule combinaison linéaire pouvant se transformer selon cette représentation parfaitement symétrique ne peut que faire intervenir en parts égales les 3 orbitales. On aurait obtenu la même chose avec $s_2$ ou $s_3$ comme vecteur arbitraire de départ.
La représentation 2 est elle aussi unidimensionnelle donc $P_2 s_1=\frac{n_2}{n_G} \sum_g \chi_2^{\dagger}(g) U(g) s_1$ doit pouvoir nous donner le vecteur irréductible recherché. On obtient :
$$ \begin{aligned} P_2 s_1 & =\frac{1}{6}\left[U(e) s_1-U(a) s_1-U(b) s_1-U(c) s_1+U(d) s_1+U(f) s_1\right] \\ & =\frac{1}{6}\left[s_1-s_1-s_3-s_2+s_2+s_3\right] \\ & =0 \end{aligned} $$
puisque $\chi_2(g)$ vaut $1$ pour les rotations et l’élément neutre, et $-1$ pour les réflexions. Et on obtient bien la même chose en partant de $s_2$ ou $s_3$.
Conclusion : aucune orbitale moléculaire ayant la symétrie de la deuxième représentation irréductible ne peut être fabriquée par combinaison linéaire des 3 orbitales atomiques.
Il reste la représentation 3, qui est cette fois-ci bidimensionnelle. Deux solutions : on peut appliquer $P_{31}$ puis $P_{32}$ sur $s_1$ et obtenir ainsi les deux vecteurs irréductibles de base de $V_3$, ou on peut aussi appliquer $P_{32}^1$ sur le premier vecteur irréductible obtenu. Cette seconde méthode, plus pratique dans le cas général (avec plus de 2 dimensions), est ici plus lourde mais on va quand même voir son intérêt.
Commençons avec $P_{31} s_1$ :
$$ \begin{aligned} P_{31} s_1 & =\frac{n_3}{n_G} \sum_g D_3^{\dagger}(g)_1^1, U(g) s_1 \\ & =\frac{2}{6}\left[s_1+s_1-\frac{1}{2} s_3-\frac{1}{2} s_2-\frac{1}{2} s_2-\frac{1}{2} s_3\right] \\ & =\frac{1}{3}\left[2 s_1-s_2-s_3\right] \end{aligned} $$
Et pour l’autre :
$$ \begin{aligned} P_{32} s_1 & =\frac{n_3}{n_G} \sum_g D_3^{\dagger}(g)_2^2, U(g) s_1 \\ & =\frac{2}{6}\left[s_1-s_1+\frac{1}{2} s_3+\frac{1}{2} s_2-\frac{1}{2} s_2-\frac{1}{2} s_3\right] \\ & =0 \end{aligned} $$
Malheur, où se cache le deuxième vecteur ? On vient en fait de montrer que $s_1$ ne fait pas partie de la combinaison linéaire le formant !
Essayons d’appliquer $P_{32}$ sur $s_2$ pour le montrer :
$$ \begin{aligned} P_{32} s_2 & =\frac{n_3}{n_G} \sum_g D_3^{\dagger}(g)_2^2, U(g) s_2 \\ & =\frac{2}{6}\left[s_2-s_3+\frac{1}{2} s_2+\frac{1}{2} s_1-\frac{1}{2} s_3-\frac{1}{2} s_1\right] \\ & =\frac{1}{2}\left[s_2-s_3\right] \end{aligned} $$
Ah, le voilà. Et on l’obtiendrait aussi à partir de $s_3$.
L’utilisation de $P_{32}^1$ sur $\left[2 s_1-s_2-s_3\right]$ est certes, ici, plus longue mais aboutit à coup sûr :
$$ \begin{aligned} P_{32}^1\left[2 s_1-s_2-s_3\right] & =\frac{n_3}{n_G} \sum_g D_3^{\dagger}(g)_2^1, U(g)\left[2 s_1-s_2-s_3\right] \\ & =\frac{n_3}{n_G} \sum_g D^3(g)_1^2, U(g)\left[2 s_1-s_2-s_3\right] \\ & =\frac{2}{6}\left[-\frac{\sqrt{3}}{2}\left(2 s_3-s_2-s_1\right)+\frac{\sqrt{3}}{2}\left(2 s_2-s_1-s_3\right)\right. \\ & \qquad \left.+\frac{\sqrt{3}}{2}\left(2 s_2-s_3-s_1\right)-\frac{\sqrt{3}}{2}\left(2 s_3-s_1-s_2\right)\right] \\ & =\frac{1}{3}\left[6 \frac{\sqrt{3}}{2} s_2-6 \frac{\sqrt{3}}{2} s_3\right] \\ & =\sqrt{3}\left[s_2-s_3\right] \end{aligned} $$
On obtient effectivement le même vecteur (à la normalisation près).
Comme cela sera décrit dans un prochain chapitre, les représentations irréductibles du groupe des translations discrètes $\mathrm{T_d}$ sur l’espace des vecteurs d’état pour une particule (disons un électron) sur un réseau unidimensionnel de pas $b$ sont étiquetées par un nombre réel $k$ compris entre $-\pi / b$ et $\pi / b$, et sont incarnées par les fonctions $\{e^{-i k n b}, n \in \mathbb{Z}\}$.
En partant d’un état localisé $|y\rangle$, avec $-b / 2 \leq y \leq b / 2$, on peut projeter ses composantes irréductibles :
$\displaystyle |k, y\rangle=P_k|y\rangle=\sum_n T(n)|y\rangle e^{i k n b}=\sum_n|n b+y\rangle e^{i k n b}$
Ces états sont les états propres des translations avec la valeur propre $e^{-i k m b}$. En effet :
$$ T(m)|k, y\rangle=\sum_n T(m+n)|y\rangle e^{i k n b}=\sum_{n^{\prime}} T\left(n^{\prime}\right)|y\rangle e^{i k\left(n^{\prime}-m\right) b}=|k, y\rangle e^{-i k m b} $$
De $|k, y\rangle=\sum_n|n b+y\rangle e^{i k n b}$, on déduit que les probabilités de trouver un électron dans n’importe laquelle des «cellules» du réseau sont toutes égales (les probabilités relatives valent $\left|e^{i k n b}\right|^2=1$).
Ces états sont des modes normaux, analogues aux ondes planes pour un espace continu.
On voit aussi que si $|x\rangle=|l b+y\rangle$ pour tout entier $l$, alors $P_k|x\rangle=|k, y\rangle e^{-i k l b}$, qui n’est qu’un multiple de l’état obtenu plus haut. Par conséquent, pour obtenir tous les états irréductibles distincts, il suffit de partir d’un état localisé dans une cellule quelconque et d’appliquer les opérateurs de projection.
Le dernier exemple nous montre comment les opérateurs de projection peuvent être utilisés pour passer d’une base donnée ($|x\rangle=|n b+y\rangle \equiv|n, y\rangle$, représentant des états localisés) à une base irréductible ($|k, y\rangle=P_k|0, y\rangle$, représentant des modes normaux).
Les états localisés décrivent le système physique à un instant donné. Pour prédire l’évolution temporelle de ces états, il est nécessaire de les exprimer en termes de modes normaux car ceux-là seulement ont une évolution temporelle simple, conséquence de la commutation de l’hamiltonien avec les transformations de symétrie.
Les opérateurs de projection aident aussi dans la réduction de produits de représentations en leurs éléments irréductibles et dans l’évaluation des coefficients de Clebsch-Gordan. Pour trouver les sous-espaces invariants irréductibles de $V_\mu \otimes V_\nu$, on peut partir d’un vecteur de la base originale $|k, l\rangle=\hat{e}_k^\mu \otimes \hat{e}_l^\nu$ et appliquer les opérateurs de projection $P_{\lambda i}^j|k, l\rangle$. Pour $(\lambda, j, k, l)$ fixés, les $n_\lambda$ vecteurs ($i=1, \ldots, n_\lambda$) génèrent un sous-espace invariant (du moins si la projection n’aboutit pas à un vecteur nul).
En sélectionnant différents ensembles de $(\lambda, j, k, l)$, on peut ainsi générer tous les sous-espaces invariants. La matrice de transformation entre la base originale et la nouvelle base donne les coefficients de Clebsch-Gordan.
Le théorème de Wigner-Eckart
Les opérateurs sur l’espace vectoriel des solutions physiques se transforment aussi de manière spécifique sous les symétries, et ils seront eux aussi classés selon les représentations irréductibles du groupe de symétrie, comme les vecteurs de base. L’exploitation des propriétés de transformation des opérateurs et des vecteurs d’état permet une immense simplification de la structure des quantités mesurables physiquement.
Si un ensemble d’opérateurs $\{O_i^\mu ; i=1, \ldots, n_\mu\}$ sur un espace vectoriel $V$ se transforment sous un groupe de symétrie $G$ comme :
$\displaystyle U(g) O_i^\mu U(g)^{-1}=O_j^\mu D^\mu(g)_i^j $
où $D^\mu(G)$ est une matrice d’une représentation irréductible, alors ces opérateurs sont appelés opérateurs irréductibles (parfois tenseurs irréductibles).
Et comment l’ensemble des vecteurs $O_i^\mu\left|e_j^\nu\right\rangle$ se comporte-t-il sous une transformation de groupe ?
$$ \begin{aligned} U(g) O_i^\mu\left|e_j^\nu\right\rangle & =U(g) O_i^\mu U(g)^{-1} U(g)\left|e_j^\nu\right\rangle \\ & =O_k^\mu\left|e_l^\nu\right\rangle D^\mu(g)_i^k D^\nu(g)_j^l \end{aligned} $$
Donc ces états se transforment selon la représentation produit direct $D^{\mu \times \nu}$ !
Comme vu plus haut, on peut alors exprimer cet ensemble de vecteurs en termes de vecteurs irréductibles $\left|w_{\alpha l}^\lambda\right\rangle$ :
$\displaystyle O_i^\mu\left|e_j^\nu\right\rangle=\sum_{\alpha, \lambda, l}\left|w_{\alpha l}^\lambda\right\rangle\langle\alpha, \lambda, l\,(\mu, \nu)\, i, j\rangle $
Ce qui nous permet d’arriver au théorème de Wigner-Eckart :
Théorème de Wigner-Eckart :
soit $\{O_i^\mu\}$ un ensemble d’opérateurs tensoriels irréductibles, alors :
$\displaystyle \left\langle e_l^\lambda\right| O_i^\mu\left|e_j^\nu\right\rangle=\sum_\alpha\langle\alpha, \lambda, l\,(\mu, \nu)\, i, j\rangle\left\langle\lambda\|O^\mu\| \nu\right\rangle_\alpha $
où $\left\langle\lambda|O^\mu| \nu\right\rangle_\alpha \equiv \frac{1}{n_\lambda} \sum_k\left\langle e_k^\lambda \mid w_{\alpha k}^\lambda\right\rangle$ est un élément de matrice réduit.
Par rapport à la relation précédente, on ne fait qu’utiliser l’orthogonalité des sous-espaces irréductibles engendrés par des vecteurs irréductibles de représentations différentes (ici $\left|e_l^\lambda\right\rangle$ et $\left|e_j^\nu\right\rangle$), ce qui permet de fixer $\lambda$ et $l$ dans la somme.
Le théorème de Wigner-Eckart permet de séparer le facteur dépendant de la géométrie (les coefficients de Clebsch-Gordan) du facteur contenant la physique (les éléments de matrice réduits, qui contiennent les propriétés spécifiques des états et des opérateurs).
La multitude d’éléments de matrice du membre de gauche sont tous déterminés par quelques éléments de matrice réduits. Les coefficients de Clebsch-Gordan du membre de droite, qui contiennent toutes les dépendances en $i$, $j$ et $l$, sont entièrement déterminés par la théorie des groupes et se retrouvent dans des tables publiées un peu partout.
Dans beaucoup d’applications importantes, telles que la symétrie de rotation 3D, chaque représentation irréductible $\lambda$ n’apparaît qu’une fois dans la réduction du produit direct $\mu \times \nu$ ; alors $\alpha=1$ et il n’y a qu’un élément de matrice réduit pour chaque $(\mu, \nu, \lambda)$.
L’une des principales utilisations du théorème de Wigner-Eckart concerne l’étude des couplages de moments angulaires en mécanique quantique.
L’interaction électromagnétique est invariante par rotation 3D, de groupe de symétrie $\mathrm{R_3}$. Une transition électromagnétique entre un état de moment angulaire $|j, m\rangle$ et un état $\left|j^{\prime}, m^{\prime}\right\rangle$ s’accompagne de l’émission d’un photon de moment angulaire $(s, \nu)$.
Comme on l’a déjà évoqué, le premier «nombre quantique» ($s$, $j$ ou $j^{\prime}$) correspond à la magnitude du moment angulaire, et le second ($\nu$, $m$ ou $m^{\prime}$) à sa composante sur un «axe de quantification» ; ce dernier ne peut prendre que $2s+1$ valeurs : $-s,-s+1, \ldots, s$ ($2j+1$ valeurs pour $m$ et $2j^{\prime}+1$ valeurs pour $m^{\prime}$).
L’état quantique du photon est un élément de la base irréductible issue de la décomposition de l’espace produit $|j, m\rangle \otimes\left|j^{\prime}, m^{\prime}\right\rangle$ correspondant au couplage.
On se restreint au cas $j=j^{\prime}=1$ et $s=1$, ce qui laisse a priori 9 transitions possibles :
La mécanique quantique nous dit que la probabilité, donc l’intensité, de chaque transition est proportionnelle à $|f|^2$ avec $f=\left\langle j^{\prime} m^{\prime}\right| O_\nu^s|j m\rangle$ où $O_\nu^s$ est «l’opérateur de transition multipolaire» du processus.
On peut alors utiliser le théorème de Wigner-Eckart, impliquant $f=f_0\left\langle j^{\prime}, m^{\prime}(s, j) \nu, m\right\rangle$ où $f_0$ est «l’élément de matrice réduit» et $\left\langle j^{\prime}, m^{\prime}(s, j) \nu, m\right\rangle$ le coefficient de Clebsch-Gordan.
Conséquence : les 9 transitions potentielles sont déterminées par une seule constante $f_0$. Et on trouve les coefficients de Clebsch-Gordan dans les tables ; $\left\langle 1, m^{\prime}(1,1) \nu, m\right\rangle$ n’est non nul que pour $m^{\prime}=\nu+m$, et les valeurs sont données dans le tableau suivant :
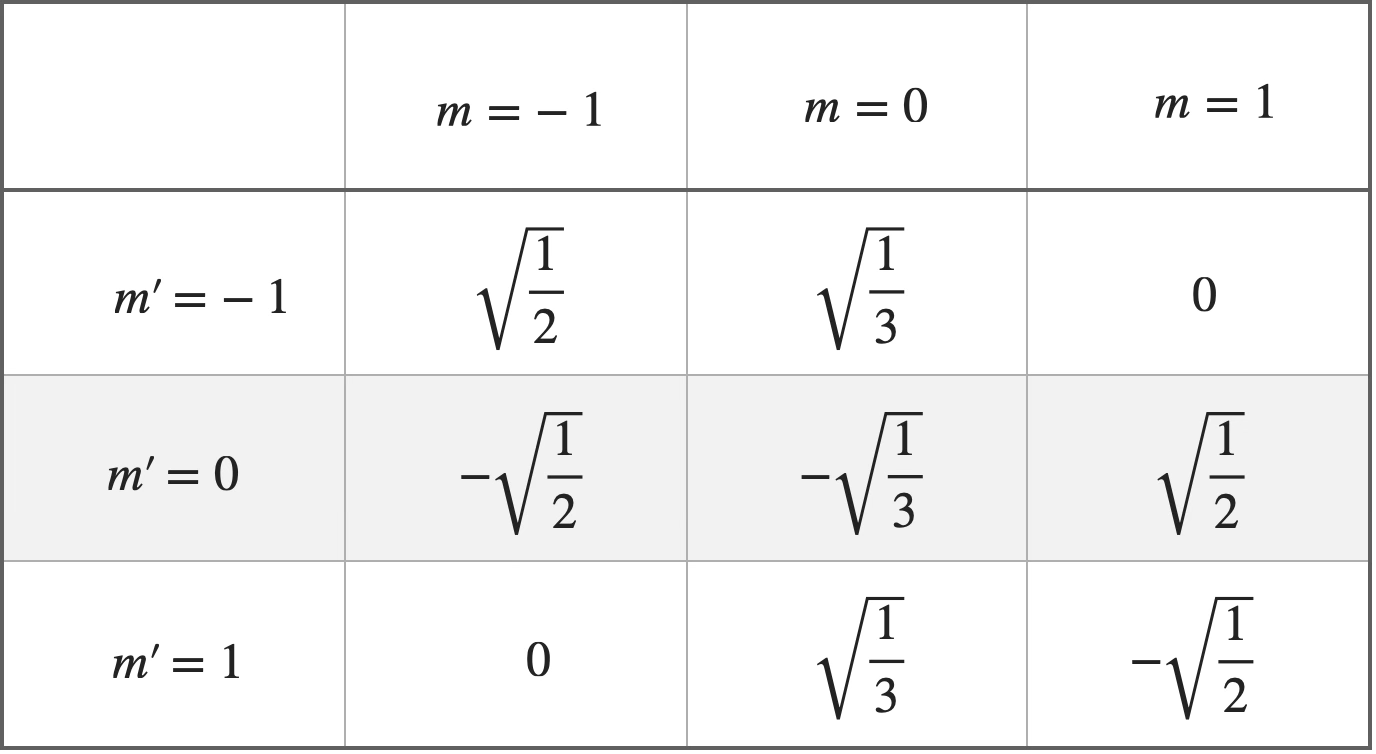
Ce qui permet de prédire qu’il doit y avoir 7 transitions distinctes, dont les intensités relatives («rapports de branchement») respectives sont représentées sur le schéma suivant :
Mais en réalité, une autre symétrie, l’inversion spatiale (conservation de la parité), interdit 3 autres transitions (celles correspondant à une non-inversion de la parité entre l’état de départ et l’état final : $1 \rightarrow 1$, $0 \rightarrow 0$ et $-1 \rightarrow-1$).
Vers les groupes continus
Jusqu’à maintenant, les éléments des groupes considérés étaient par défaut supposés dénombrables. Mais beaucoup de symétries, dont certaines ont d’ailleurs déjà été évoquées, peuvent s’opérer par variations infinitésimales, donc continûment. C’est le cas, en particulier, des translations et des rotations.
La plupart des résultats obtenus restent valables mais il nous faut de nouveaux outils pour réussir à décrire et structurer des infinités d’éléments. C’est ainsi qu’on va être amené à parler différenciation ou topologie…
La théorie mathématique des groupes continus est généralement appelée la théorie des groupes de Lie. Grossièrement, un groupe de Lie est un groupe dont les éléments peuvent être paramétrés de façon lisse et analytique.